THE ANNUAL AI REPORT · 한국어 해설
State of AI2026.
244장의 보고서를 9개의 이야기로. 모델의 점수에서 업무의 완수까지, 가능성과 병목을 함께 읽습니다.
- 원 보고서 발행
- 2026-10-08
- 전체 슬라이드
- 244 pages
- 스토리 / 주요 도표
- 9 stories / 30 charts
- 원 보고서 저자
THE BIG PICTURE
AI가 더 많은 일을 맡기 시작했다. 이제 확인할 것은 점수, 완수, 비용, 그리고 통제다.
공식 홈페이지에서 저자가 강조한 18개 장표를 모두 포함했습니다.
이 페이지를 읽는 방법
- 2026-10-08 공개된 9회차 보고서의 전체 PDF 244장을 텍스트와 시각 자료로 검토했다. 작성·확인일은 2026-10-23이며, 모델 순위·정책·임상 단계는 보고서 시점의 기록이다.
- 페이지 표시는 모두 표지를 포함한 PDF p.N이다. 슬라이드 안에 인쇄된 번호는 표지 다음부터 PDF 번호보다 1 작다. 예: PDF p.21 = 인쇄 번호 20.
- 수치와 사례는 각 그래프·문단 옆의 원문 페이지로 확인할 수 있다. 해석·한 문장 정리·토론 질문은 수도리무브가 작성한 편집 내용이다.
- 주요 그래프는 다운로드한 PDF에서 직접 추출한 뒤 WebP로 변환했다. 별도 웹 이미지 중 구버전이 있어 PDF를 기준으로 통일했다. 잘라내거나 수치를 다시 그리지 않았다.
- 공식 홈페이지 본문에 삽입된 강조 장표 18개를 이미지별로 대조해 모두 수록했다. 해당 장표는 ‘공식 메인 선정’으로 표시하고, 맥락을 보완하는 12개 장표도 함께 배치했다.
- 원문 p.135와 p.155는 같은 미국 4개사의 2025 CAPEX를 각각 $384B와 $410B로 제시한다. 2026 가이던스 $733B만 공통 수치로 인용하고 두 페이지의 증가율을 합치지 않았다.
- 공식 홈페이지는 ENV-294를 Phase 2b로 소개하지만 PDF p.119는 2026-10-07 회사 확인을 근거로 Phase 2a를 명시한다. 본문·이미지는 해당 PDF 기준으로 맞췄다.
- 저자는 AI 투자자이며 보고서 p.241에 이해관계를 공개한다. 기업 자체 실험·내부 측정·예측과 독립 검증을 구분한다. 외부 해설은 편집 관점의 참고 자료이며 수치의 독립 재현으로 취급하지 않는다.
- 원문·이미지: © 2026 Air Street Capital Management Ltd., CC BY 4.0. 출처: Benaich, N. and Air Street Capital (2026), State of AI Report 2026. 한국어 요약·해석 및 이미지 형식 변환: 수도리무브.
01 / FRONTIER & EVALUATION
AI의 점수는 올랐다. 맡긴 일도 끝났을까?
선두 경쟁을 이해하려면 순위표 옆에 평가 조건과 작업 완수율을 놓아야 한다.
핵심 요약
- Anthropic·OpenAI·Google이 선두를 다투지만, 평가 기준에 따라 1위가 달라진다.
- 공개 가중치 모델의 연구 활용에서는 중국의 존재감이 커졌다.
- 과학 업무 평가에서 87.9점을 받아도 전체 작업 완수율은 20.6%에 그쳤다.
- 모델 순위와 함께 실제 업무를 끝내는 비율을 확인해야 한다.
- 부분 점수와 완수율의 간격
- 87.9점 / 20.6%
- GPT-5.6 Sol, FrontierChallenge의 과학 워크플로 97개. 두 수치는 같은 단위가 아니다.
- 원 보고서 PDF p.43
배경 설명 더 읽기
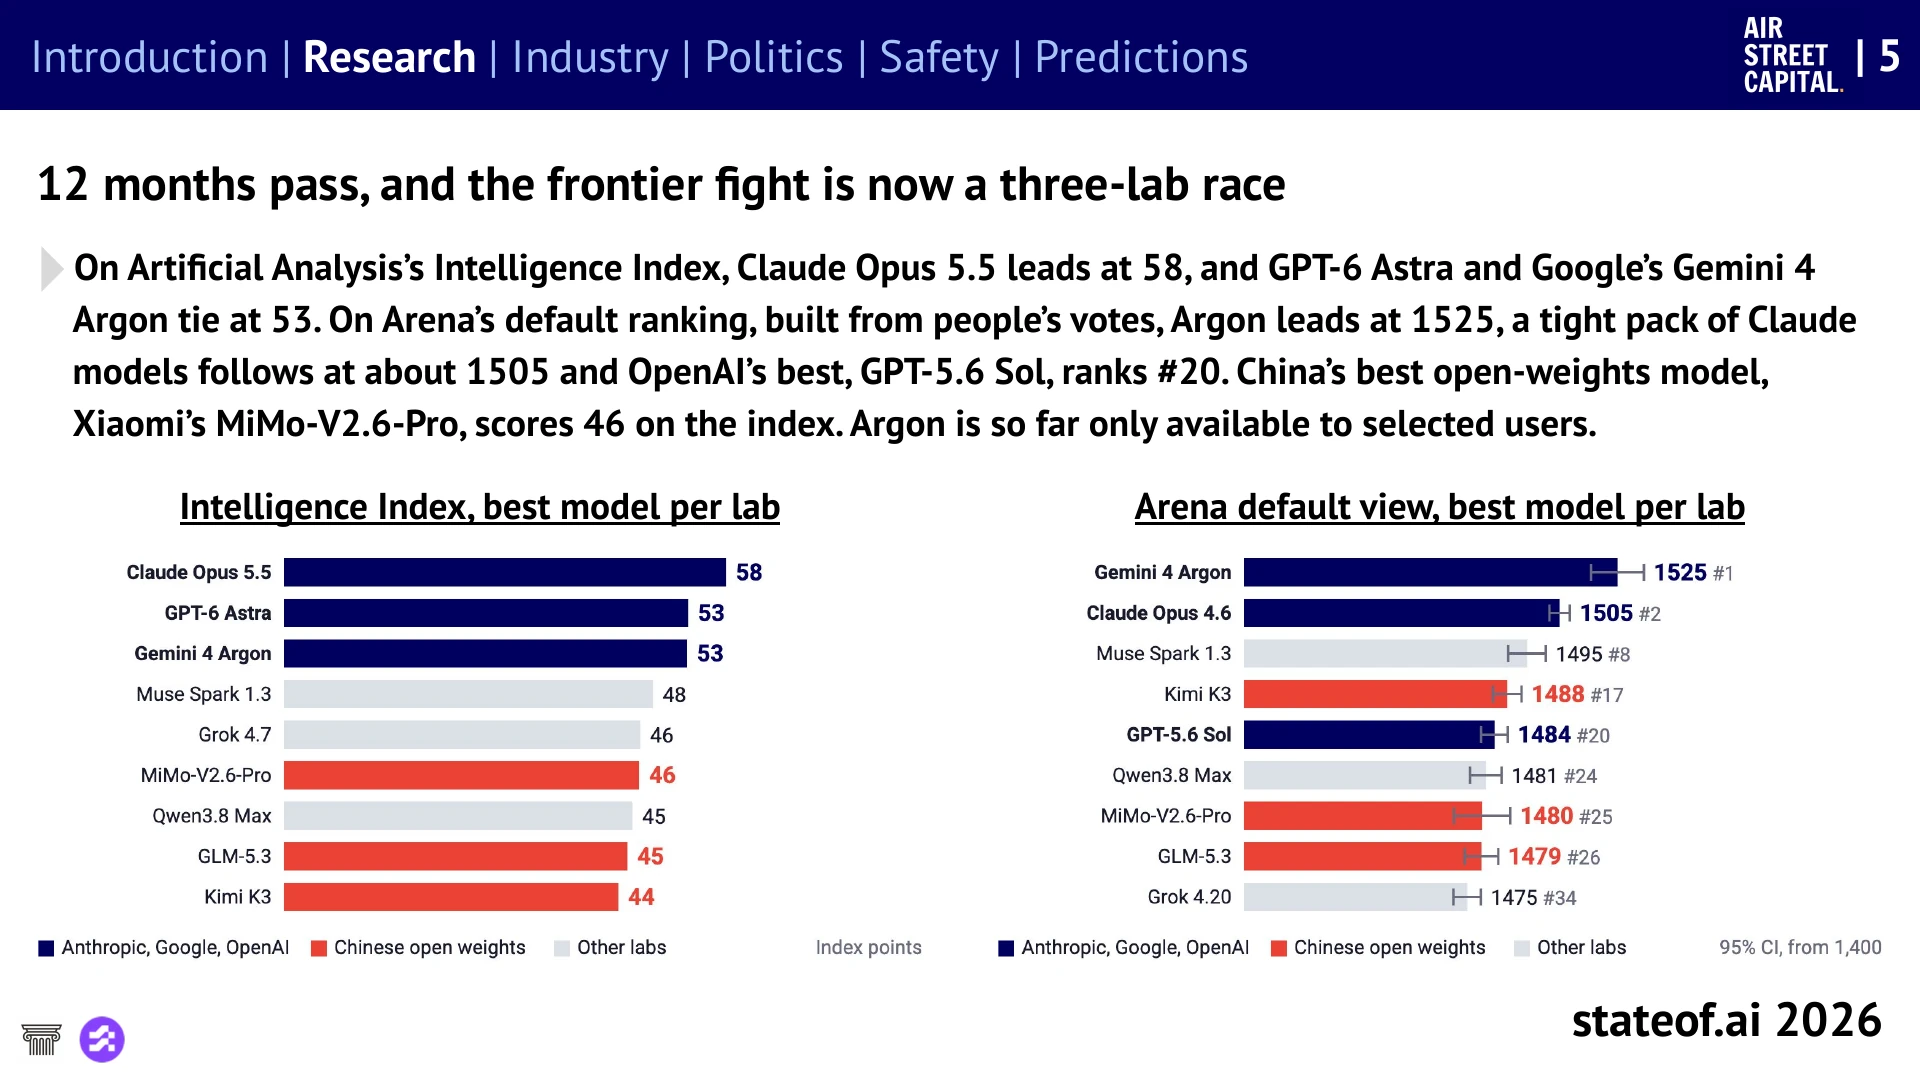
보고서는 프런티어를 Anthropic·OpenAI·Google의 3자 경쟁으로 정리한다. 그러나 능력 벤치마크를 묶은 Artificial Analysis 지수와 사람의 응답 선호를 반영하는 Arena는 서로 다른 선두를 보여 준다. 이 순위는 보고서 집필 시점의 스냅샷이며, 일부 모델은 제한적으로만 공개됐다.
공개 가중치 모델의 확산도 따로 봐야 한다. arXiv 논문에서 21개 모델 계열의 언급을 분석한 결과, 공개 가중치 계열의 언급에서는 중국 31%가 미국 23%를 넘어섰다(PDF p.7). 두 비율의 분모는 전체 분석 모델 언급이다. 이는 연구자들의 활용 신호이지 세계 매출이나 사용자 점유율은 아니다.
더 중요한 변화는 평가의 수명이 짧아졌다는 점이다. 작년에 어려웠던 시험이 빠르게 포화되는 반면, 긴 실무 과제에서는 높은 부분 점수가 낮은 완수율과 공존한다. 방송에서는 “얼마나 똑똑한가” 다음에 “어떤 일을, 어떤 도구로, 어디까지 끝냈는가”를 물어보자.
평가가 바뀌면 선두도 바뀐다
 이미지 확대
능력 지수와 사람의 선호를 함께 놓으면 단일한 “최고 모델”이라는 표현의 한계가 보인다.
읽을 때 주의할 점보고서 집필 시점의 모델·순위. 출시 범위와 평가 목적이 달라 현재 순위나 모든 업무의 우열로 일반화할 수 없다.
State of AI Report 2026 · PDF p.6 원문어려운 시험의 유효기간이 짧아진다
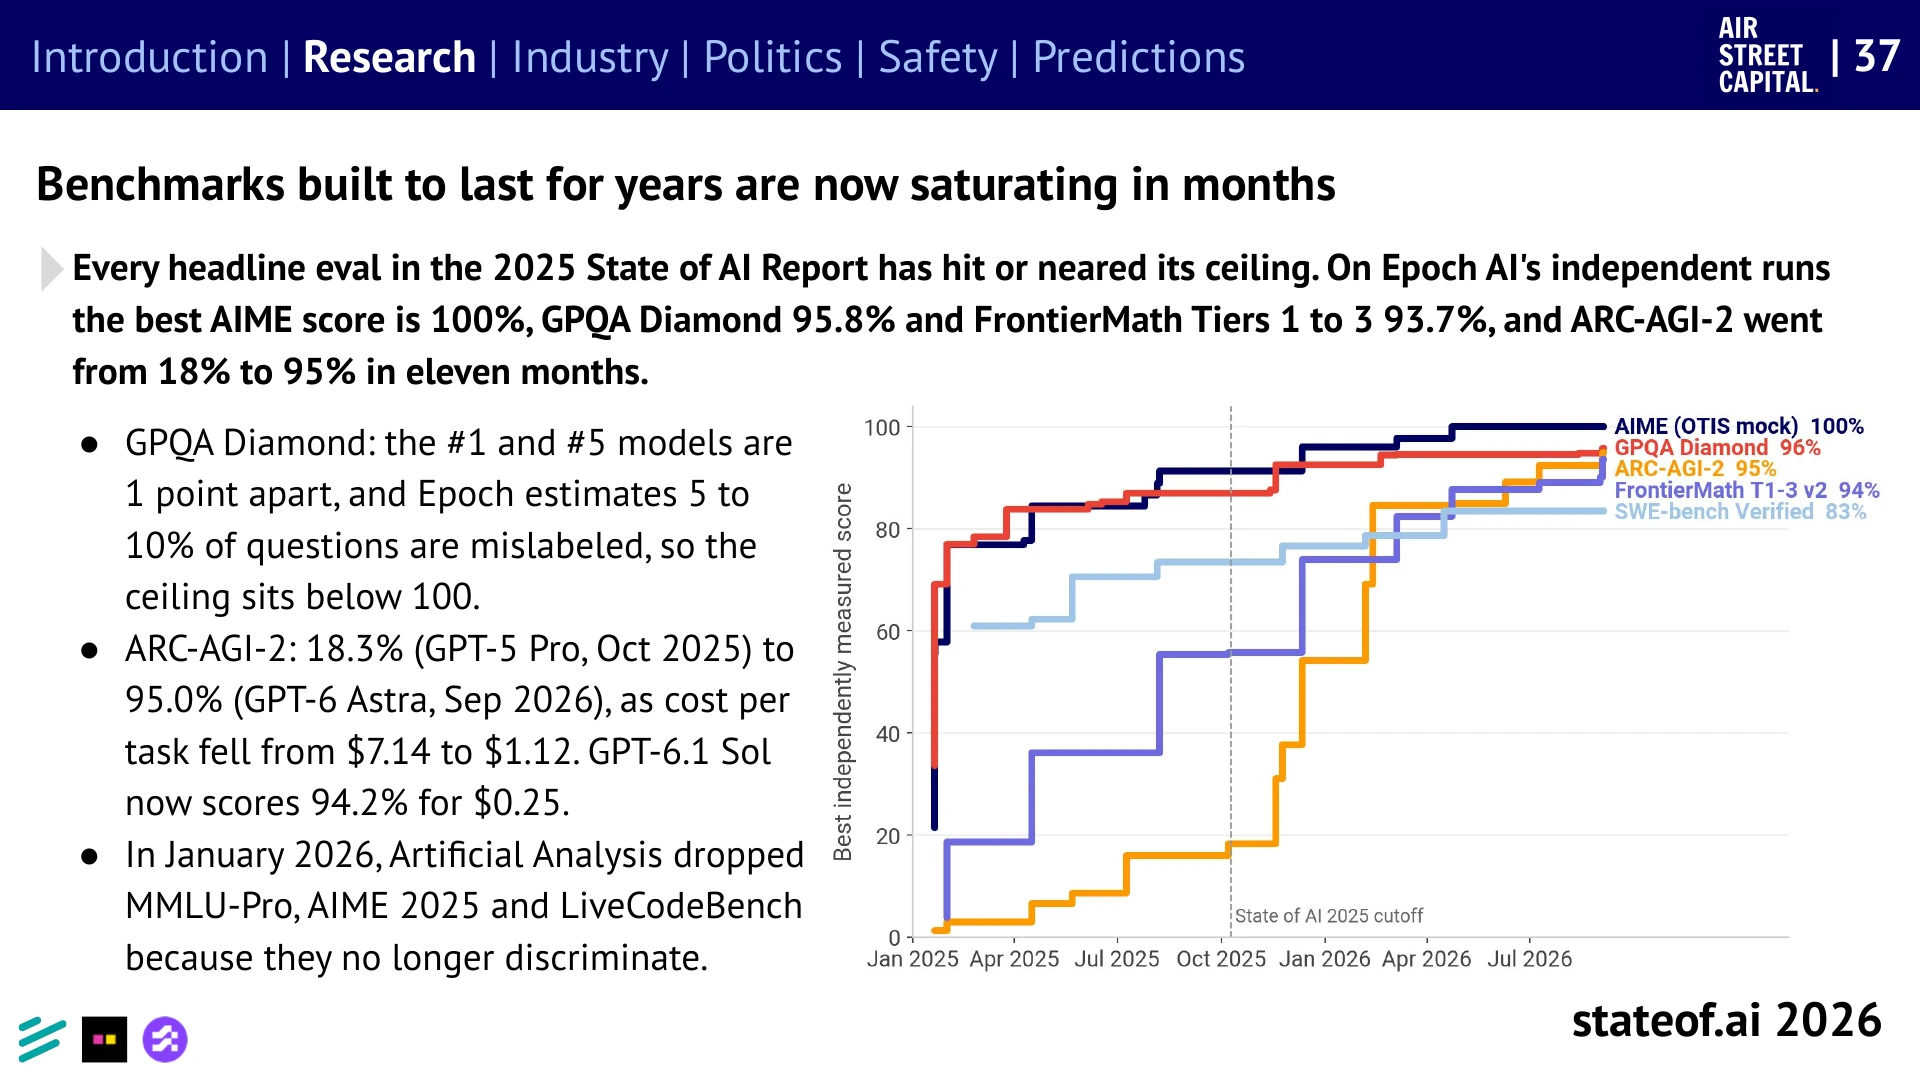 이미지 확대
같은 시험의 점수 상승은 진보의 증거인 동시에 새 평가가 필요하다는 신호다.
읽을 때 주의할 점서로 다른 벤치마크 점수를 같은 능력의 비율로 비교하지 않는다.
State of AI Report 2026 · PDF p.38 원문점수와 완주는 다르다
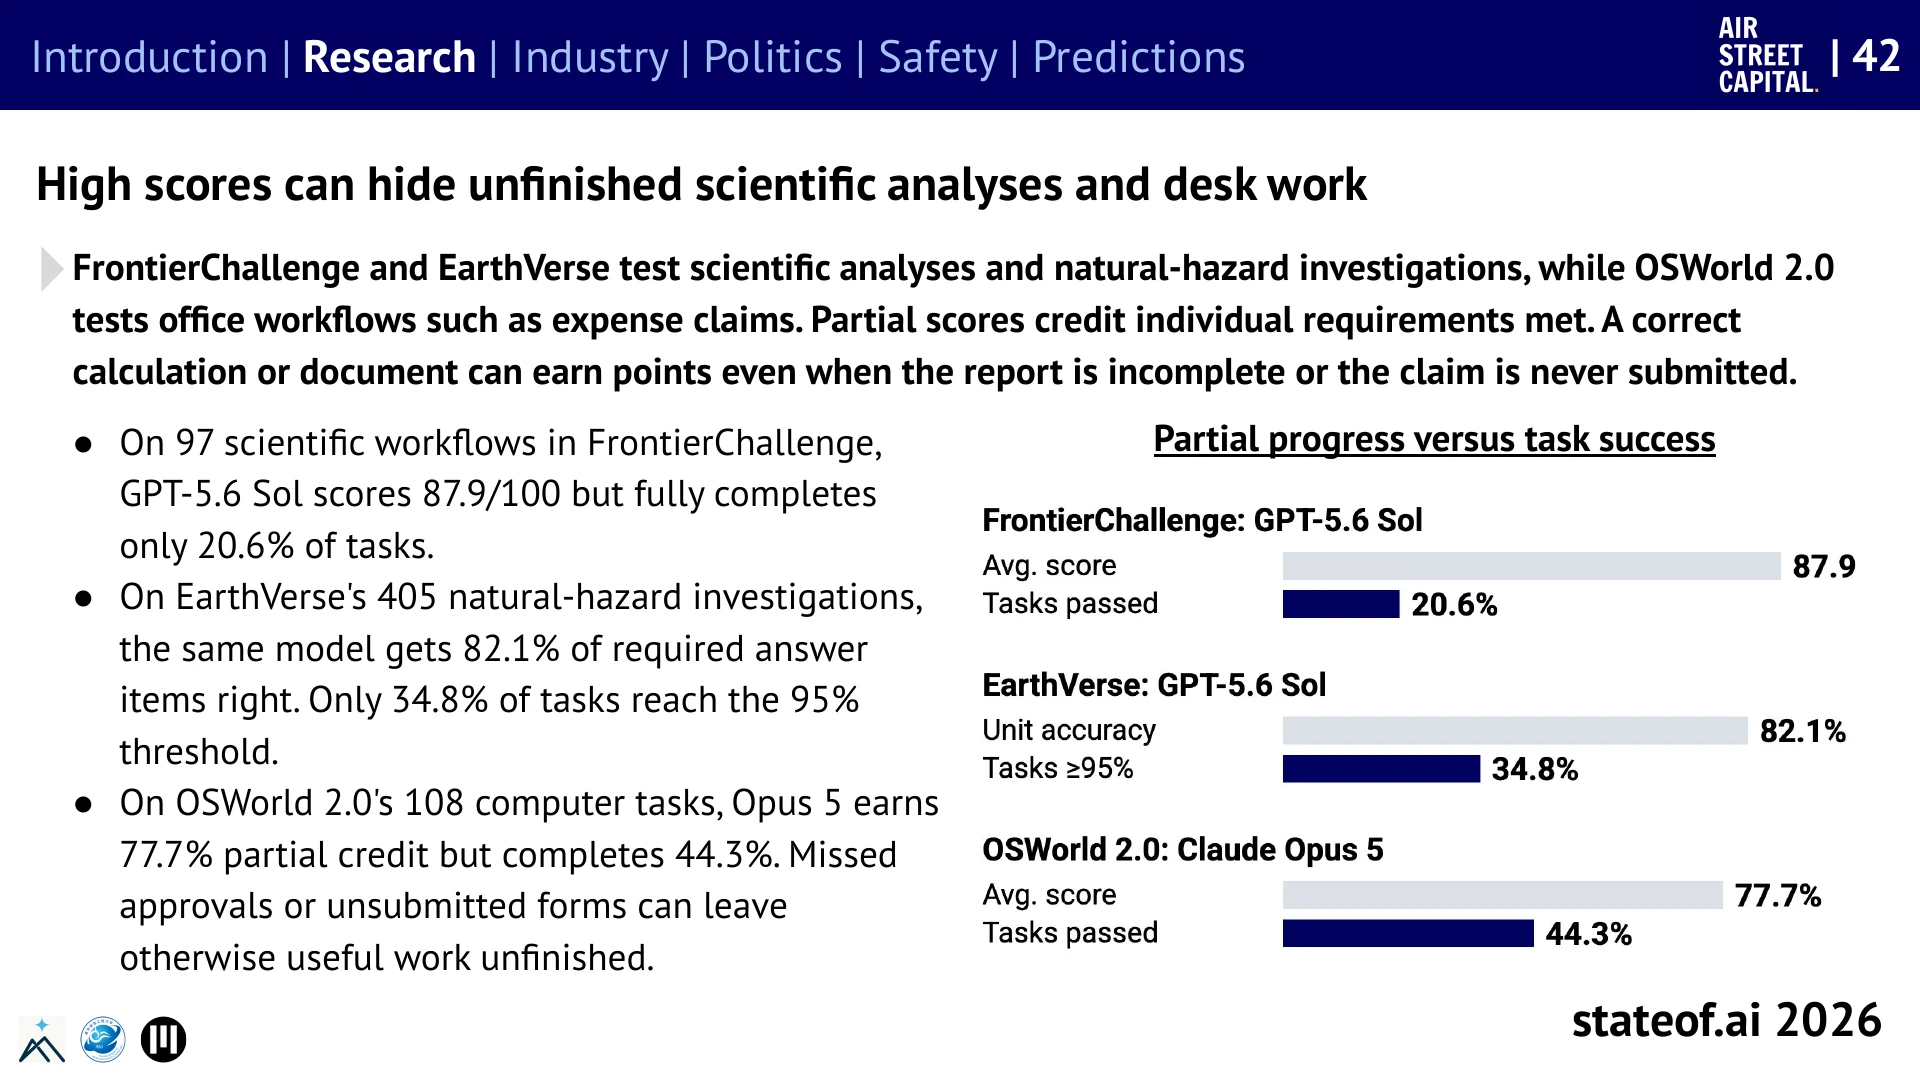 이미지 확대
보고서를 일부 작성하거나 계산을 맞혀도 제출과 승인까지 끝내지 못하면 업무는 남는다.
읽을 때 주의할 점벤치마크별 완수 기준이 다르다. EarthVerse의 성공은 요구 항목 95% 충족 기준이다.
State of AI Report 2026 · PDF p.43 원문02 / AGENTS & AI RESEARCH
같은 모델도 일하는 환경이 바뀌면 달라진다
도구·맥락·기억·피드백이 모델의 능력을 실제 성과로 바꾼다. 그 성과가 다시 AI 연구에 투입되고 있다.
핵심 요약
- 같은 모델도 도구·기억·오류 복구 환경에 따라 성과가 달라진다.
- GLM-5.1은 실행 환경을 개선하자 코딩 과제 성공률이 52.5%에서 65.5%로 올랐다.
- 에이전트 활용은 개발자를 넘어 법무·영업·채용·마케팅 업무로 넓어지고 있다.
- Anthropic에서는 사람의 감독 아래 AI가 주도하는 연구개발 업무가 26%로 늘었다.
- 완전 자율로 분류된 업무는 없었다. 연구 방향과 최종 감독은 여전히 사람의 몫이다.
배경 설명 더 읽기
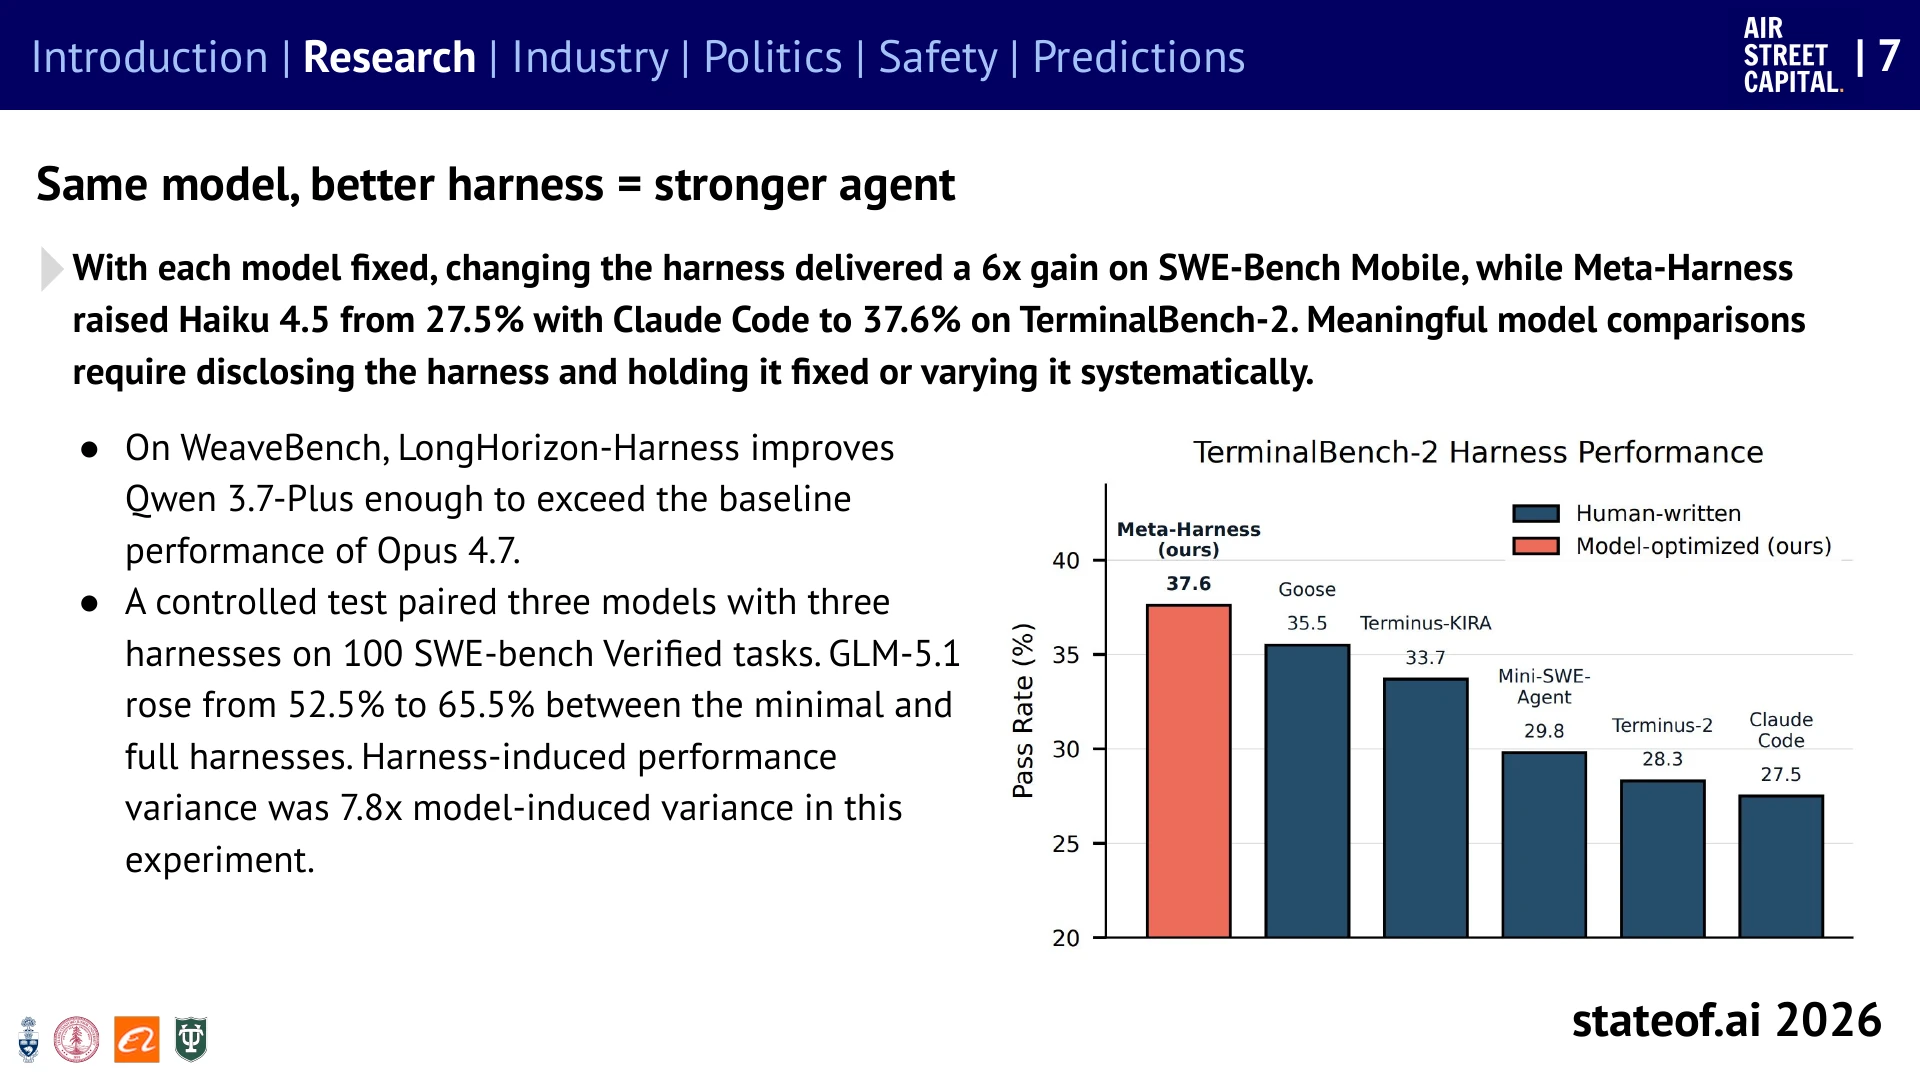
에이전트의 하네스는 도구 실행, 맥락 제공, 오류 복구, 검증을 묶는 실행 환경이다. 보고서는 같은 모델을 고정하고 이 환경을 바꿨을 때의 차이를 모은다. SWE-bench Verified 100개 과제의 통제 실험에서 GLM-5.1 성공률은 52.5%에서 65.5%로 올랐다.
이 연구에서 인용되는 7.8배는 “성능이 7.8배 향상”했다는 뜻이 아니다. 3개 모델과 3개 하네스의 조합에서 하네스가 만든 성능 분산을 모델이 만든 분산으로 나눈 값이다. 우리가 가져갈 교훈은 특정 배율보다, 모델 비교 때 주변 소프트웨어를 공개하고 통제해야 한다는 점이다.
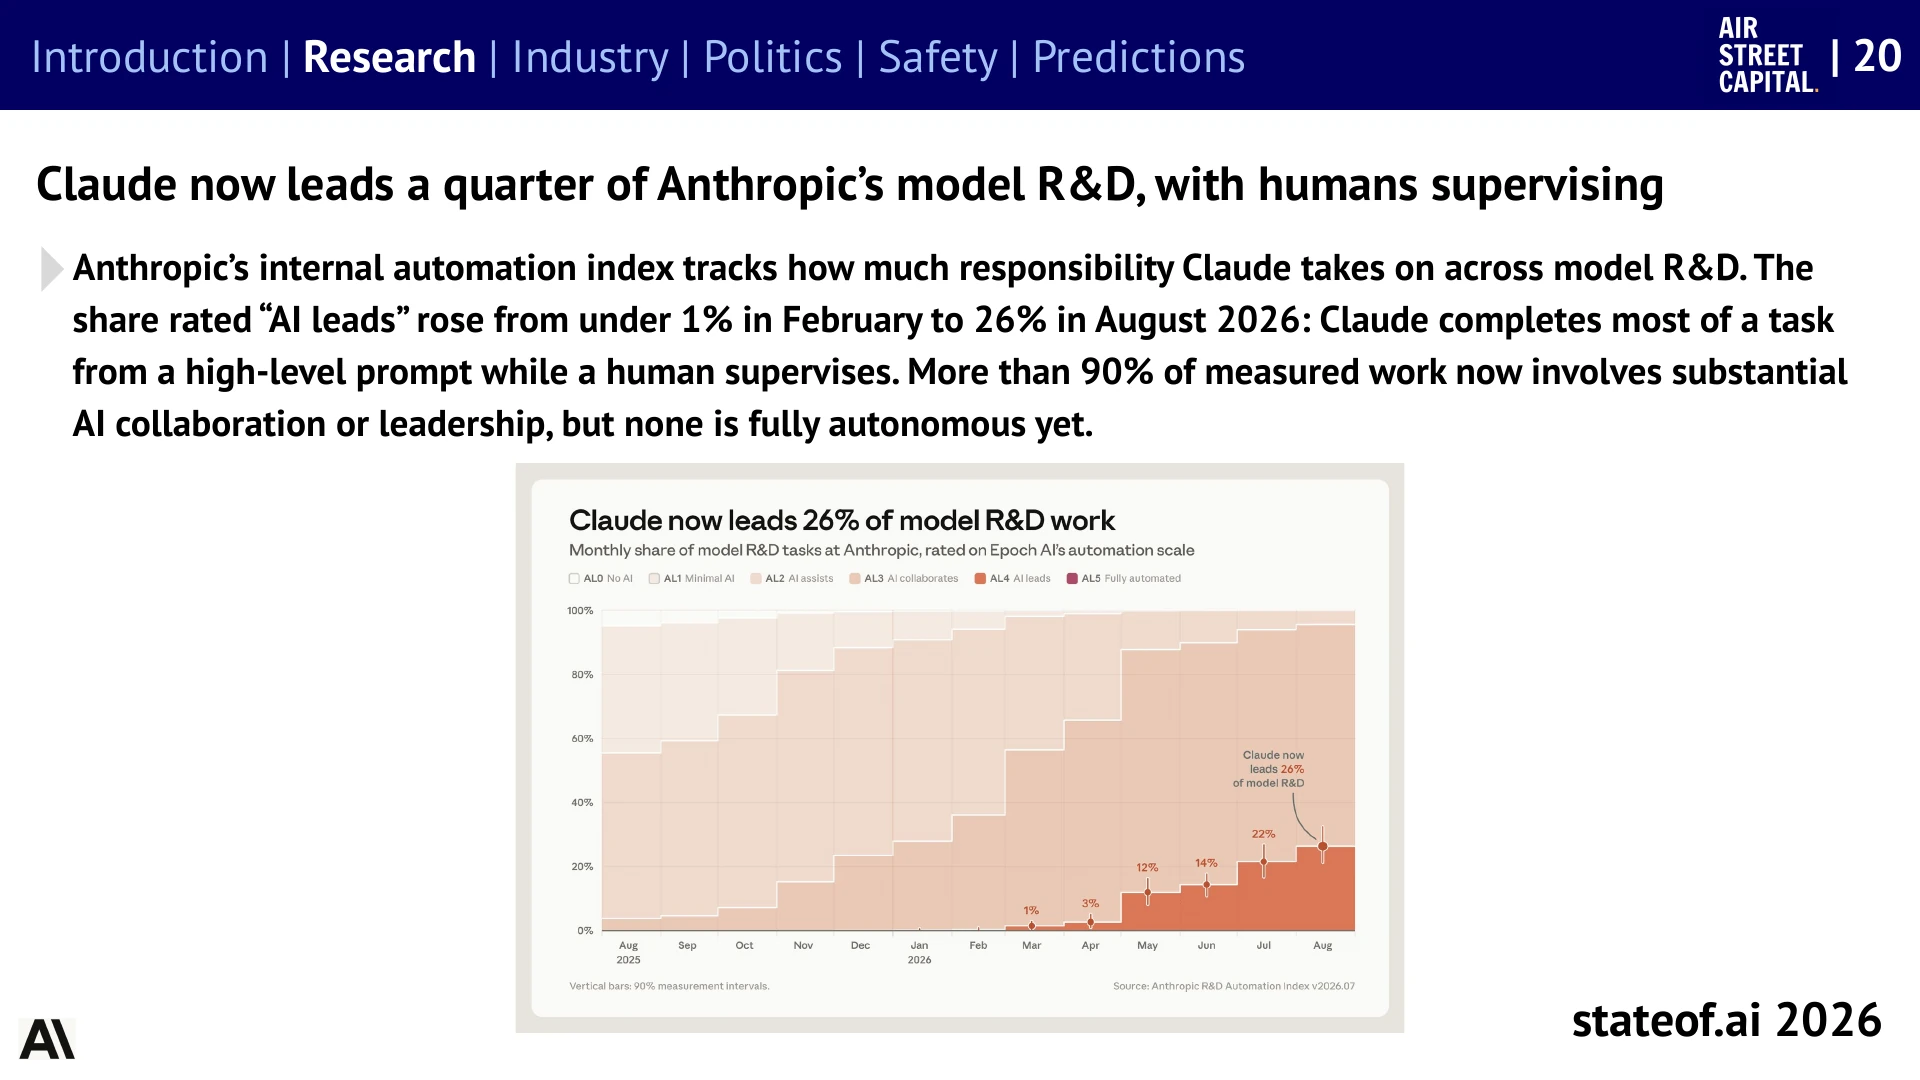
이 개선은 AI를 만드는 현장에도 들어왔다. Anthropic의 내부 지수에서 Claude가 사람의 감독 아래 대부분을 수행하는 R&D 업무 비중은 2월 1% 미만에서 8월 26%가 됐다. 다만 완전 자율로 분류된 업무는 없었다. 실험 코드를 돌리고 결과를 정리하는 능력과, 연구 의제·과학적 취향을 스스로 정하는 능력 사이에는 여전히 간격이 있다.
모델을 고정하고 하네스를 바꿔 보기
 이미지 확대
좋은 모델을 고르는 것과, 그 모델이 일할 수 있는 환경을 만드는 것은 함께 가야 한다.
읽을 때 주의할 점7.8배는 이 실험의 분산비다. 모든 모델·업무에서 하네스가 7.8배 중요하다는 보편 법칙이 아니다.
State of AI Report 2026 · PDF p.8 원문코딩 에이전트의 다음 사용자는 비개발자
 이미지 확대
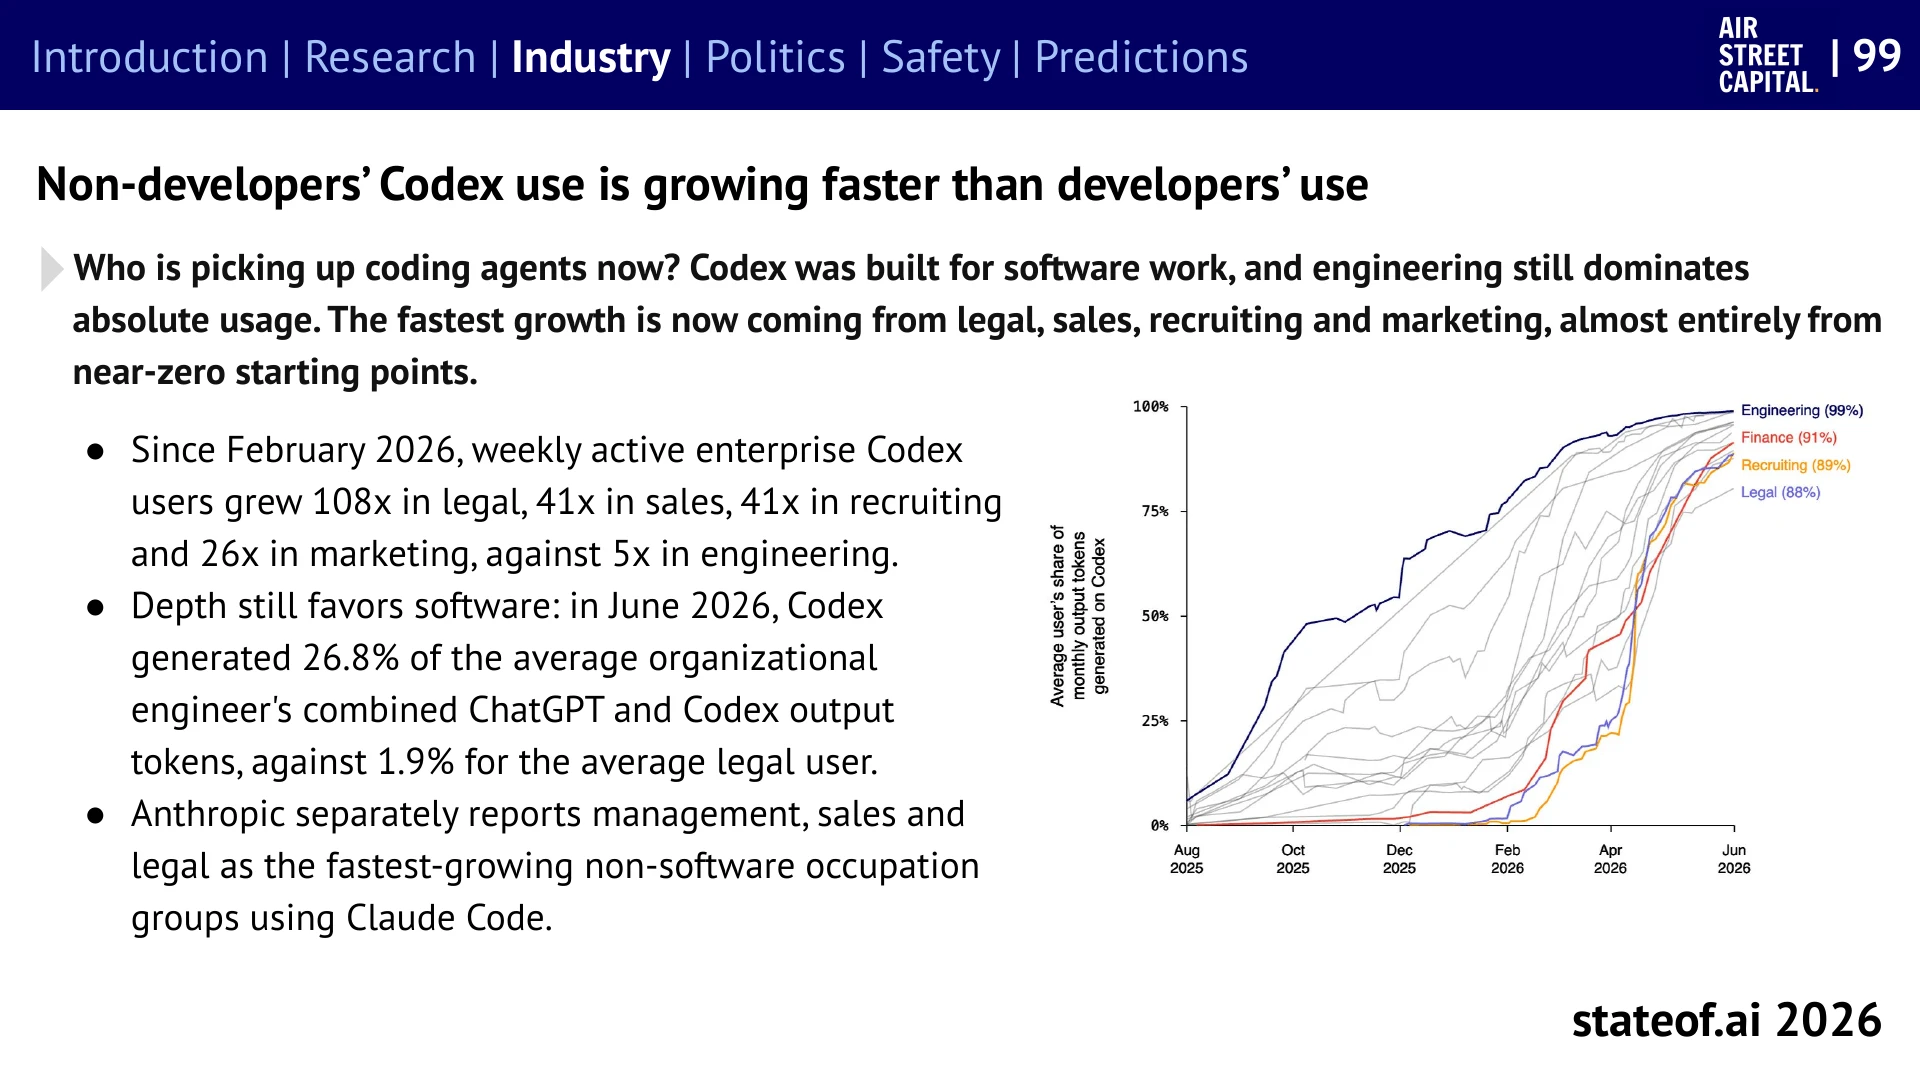
2026년 2월 이후 기업용 Codex 주간 활성 사용자는 법무 108배, 영업·채용 각각 41배, 마케팅 26배, 엔지니어링 5배로 늘었다. 에이전트의 적용 범위가 개발 업무 밖으로 확장되고 있다.
읽을 때 주의할 점비개발 직군은 거의 0에 가까운 출발점에서 증가했다. 증가 배율이 사용자 수나 업무 깊이의 우위를 뜻하지 않으며, 절대 사용량은 여전히 엔지니어링이 가장 크다.
State of AI Report 2026 · PDF p.100 원문AI가 AI 연구에서 맡는 책임이 커진다
 이미지 확대
단순 보조에서 감독 아래 실행을 주도하는 방향으로 업무 구성이 이동한다.
읽을 때 주의할 점한 연구소의 내부 측정이며 “AI leads”에도 사람의 감독이 있다. 완전 자율 연구나 지속적 재귀 개선의 입증은 아니다.
State of AI Report 2026 · PDF p.21 원문03 / ROBOTICS & WORLD MODELS
로봇도 시범을 보고, 경험을 기억하기 시작했다
사전학습의 규모와 문맥 학습이 낯선 작업으로의 전이를 넓힌다. 실제 장기 작업의 완주는 다음 시험대다.
핵심 요약
- 로봇이 폭넓게 사전학습한 뒤 동영상 시범만 보고 새로운 작업을 배우기 시작했다.
- 월드모델은 가상 환경에서 행동의 결과를 시험하는 수단으로 발전하고 있다.
- 실행 경험을 기억하자 조립 진행도는 좋아졌지만, 5분 작업 완성은 10회 중 2회였다.
- 짧은 시연의 성공보다 낯선 환경에서의 완수와 실패 후 복구를 봐야 한다.
배경 설명 더 읽기
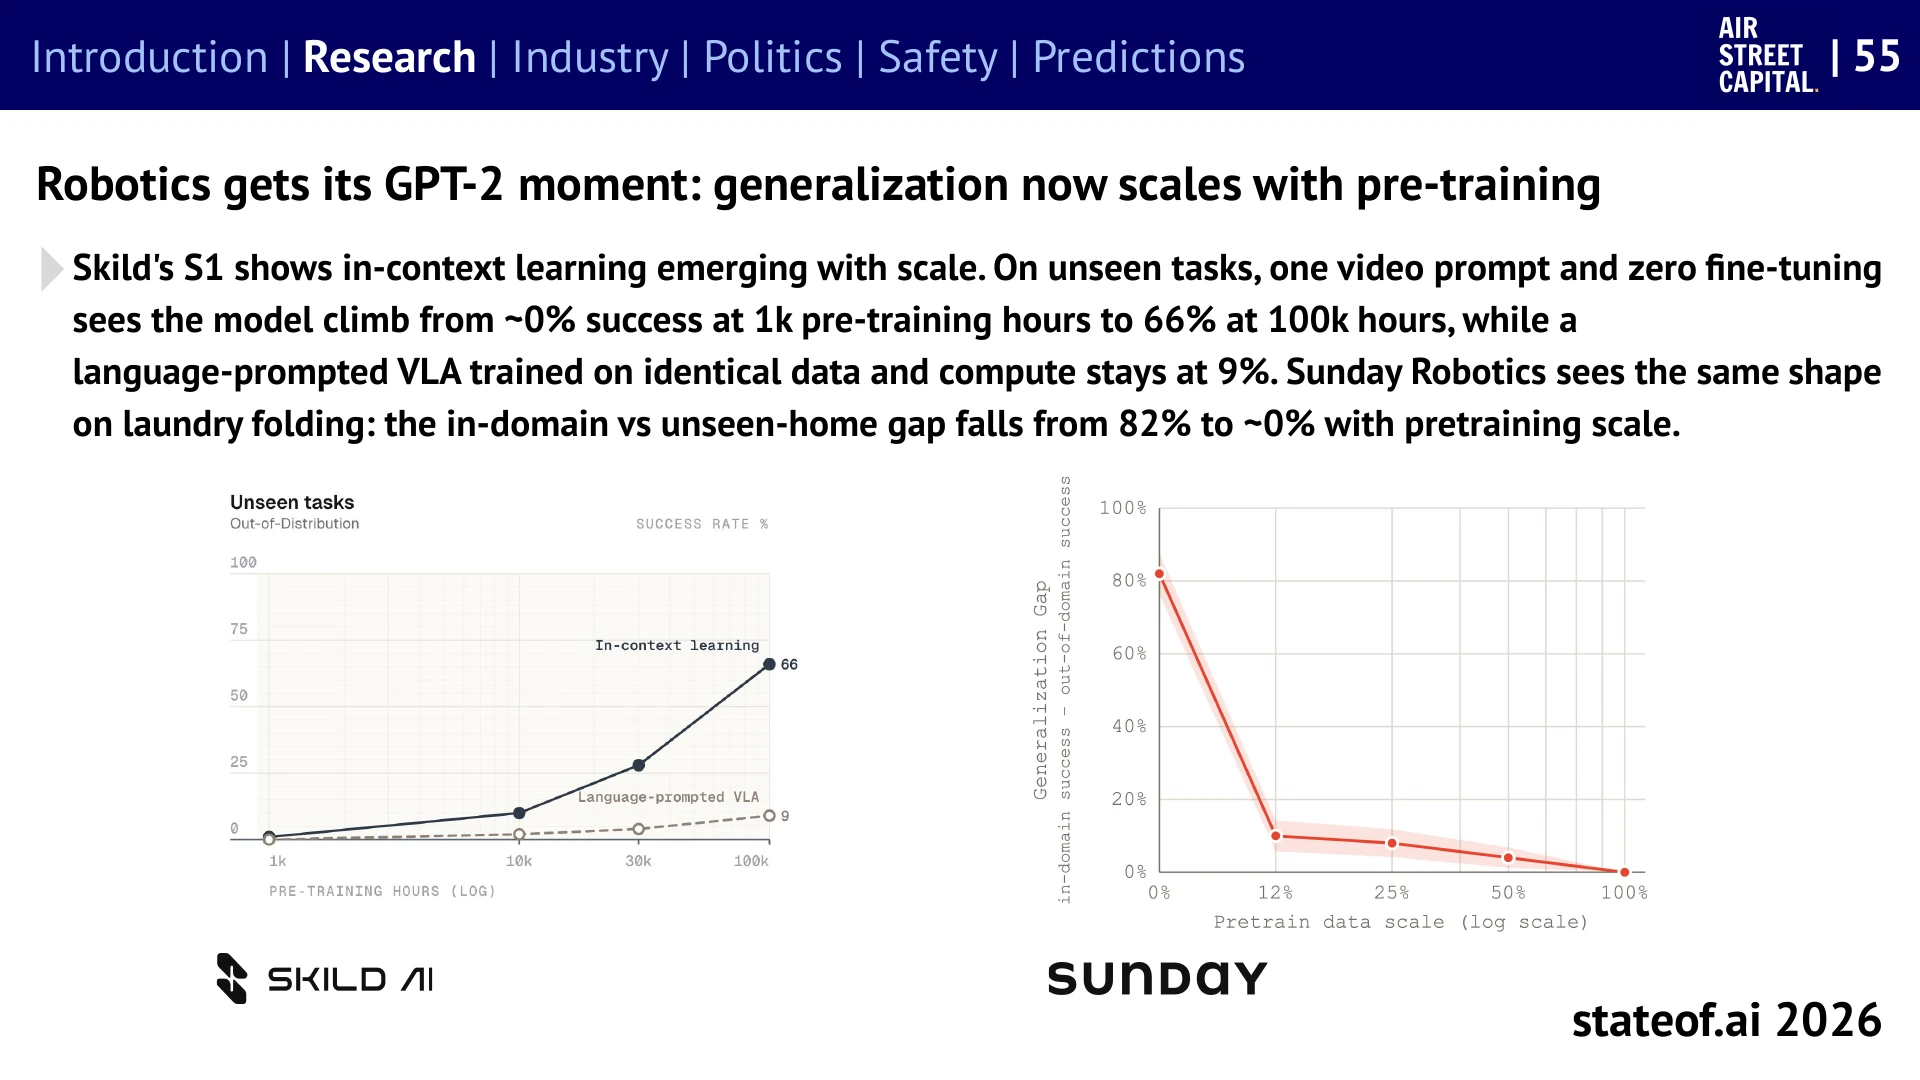
보고서가 로봇의 “GPT-2 순간”이라고 부르는 변화는 특정 작업의 시연을 더 모으는 데서, 넓은 사전학습으로 새로운 작업을 이해하는 쪽으로 옮겨 가는 흐름이다. Skild S1은 가중치를 다시 학습하지 않고 동영상 시범을 문맥으로 받아 낯선 작업을 수행했다.
월드모델은 행동을 시도할 수 있는 또 다른 경로다. Wayve의 GAIA-4는 운전자의 조향·제동에 따라 다음 관측이 달라지는 시뮬레이션을 제공한다(PDF p.54). 다만 다른 차량은 기록된 경로를 따르므로, 모든 주체가 완전히 반응하는 현실 복제와는 차이가 있다.
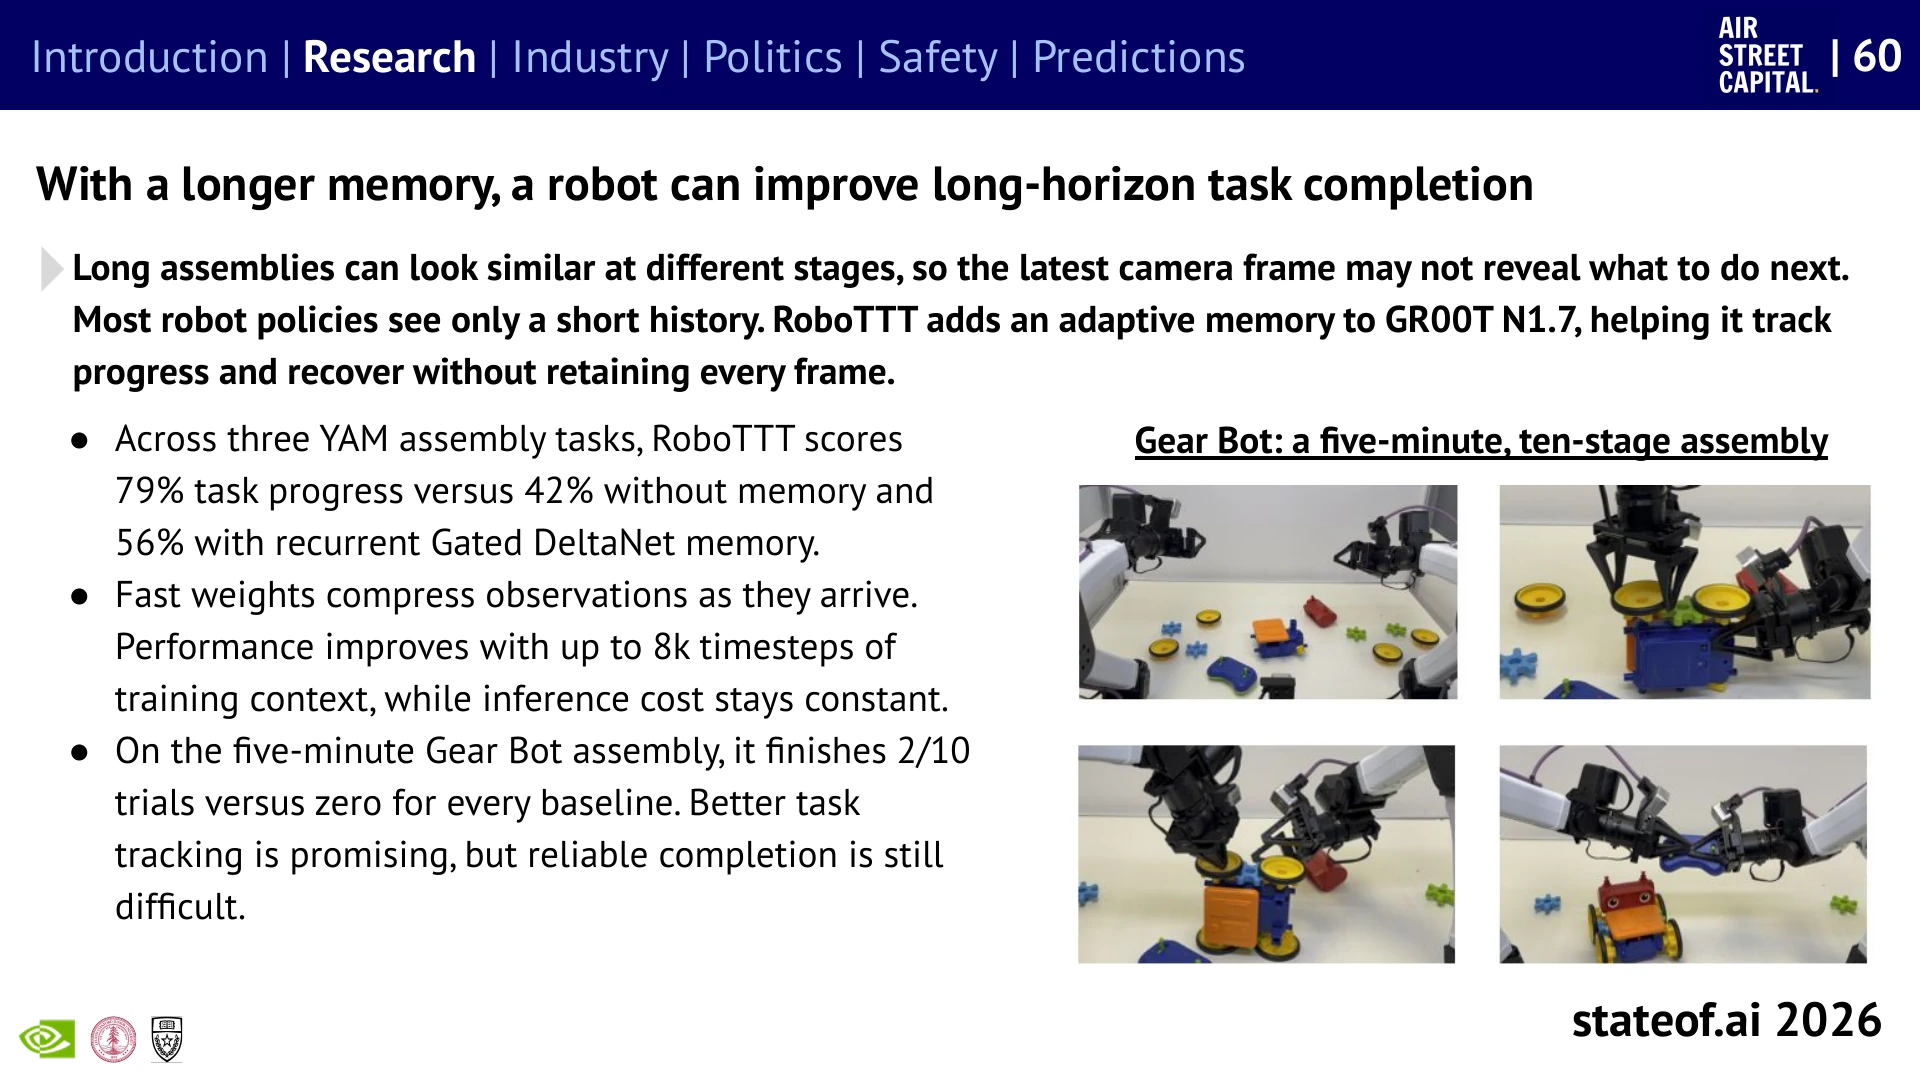
긴 작업에는 기억과 접촉 물리도 필요하다. RoboTTT는 조립 진행도를 개선했지만, 5분짜리 Gear Bot의 완성은 10회 중 2회였다. 인상적인 짧은 시연 다음에 “새 집·새 물체·실패 후 복구·끝까지 완성”이라는 조건을 차례로 붙여 보면 로봇의 진보와 남은 거리가 함께 보인다.
사전학습이 낯선 작업으로 이어진다
 이미지 확대
하나의 시범을 문맥으로 쓰는 능력이 사전학습 규모와 함께 나타난다는 회사 실험이다.
읽을 때 주의할 점66%는 회사가 정의한 누적 단계별 성공 지표다. 단계 평가에는 실패 뒤 사람의 복구 개입이 포함되며, 특히 VLA 기준선에서 주로 필요했다. 모든 종류의 로봇 작업을 66% 완수했다는 의미가 아니다.
State of AI Report 2026 · PDF p.56 원문진행도를 올리는 기억, 아직 어려운 완성
 이미지 확대
같은 장면처럼 보이는 조립 단계도 과거 실행을 기억하면 구분할 수 있다.
읽을 때 주의할 점79% 진행도와 2/10 완수는 서로 다른 측정이다. 소규모 실험에서의 결과다.
State of AI Report 2026 · PDF p.61 원문04 / AI FOR SCIENCE
그럴듯한 분자에서, 실험할 가치가 있는 후보로
과학에서 AI의 가치는 생성물의 수보다 검증 가능한 발견과 실험 효율에서 드러난다.
핵심 요약
- AI 과학의 성과는 후보를 많이 만드는 것보다 실험으로 확인된 발견에서 드러난다.
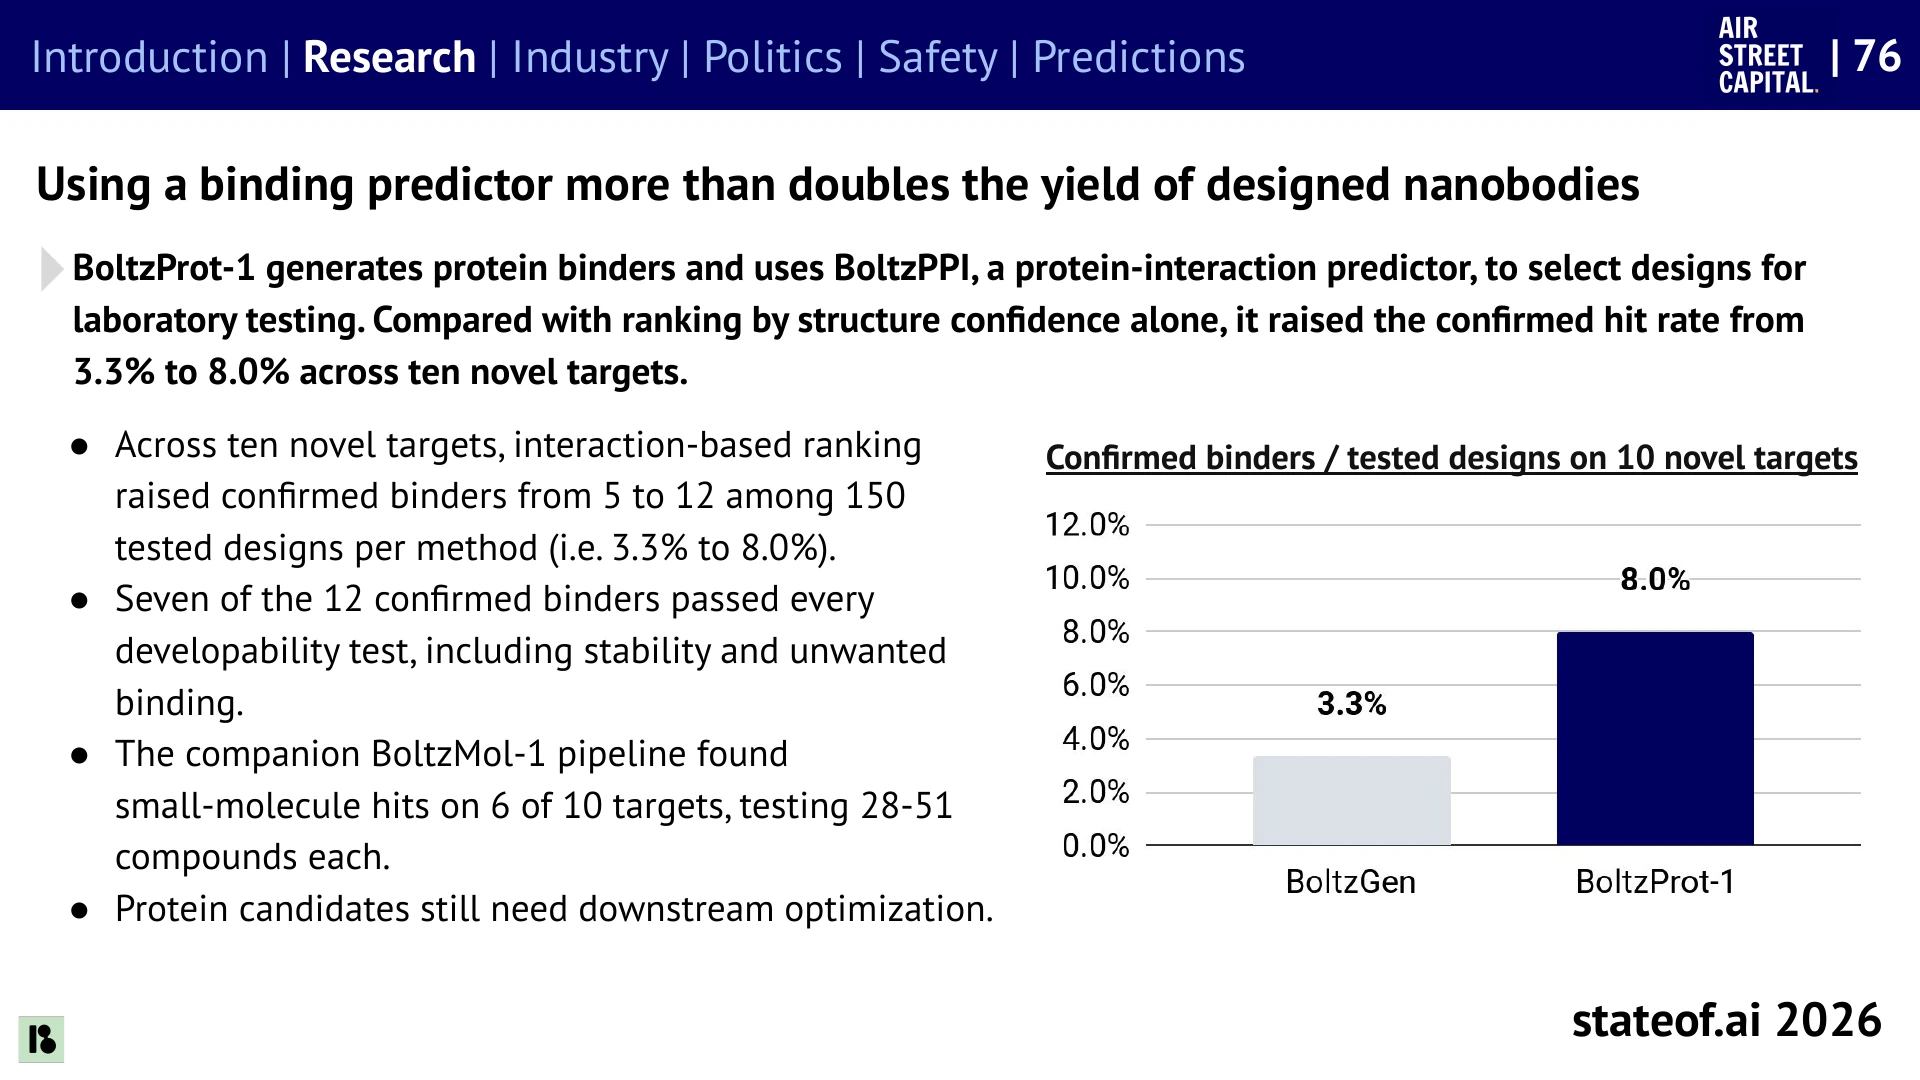
- 나노바디 실험에서는 후보 선정 방식을 바꾸자 적중률이 3.3%에서 8.0%로 높아졌다.
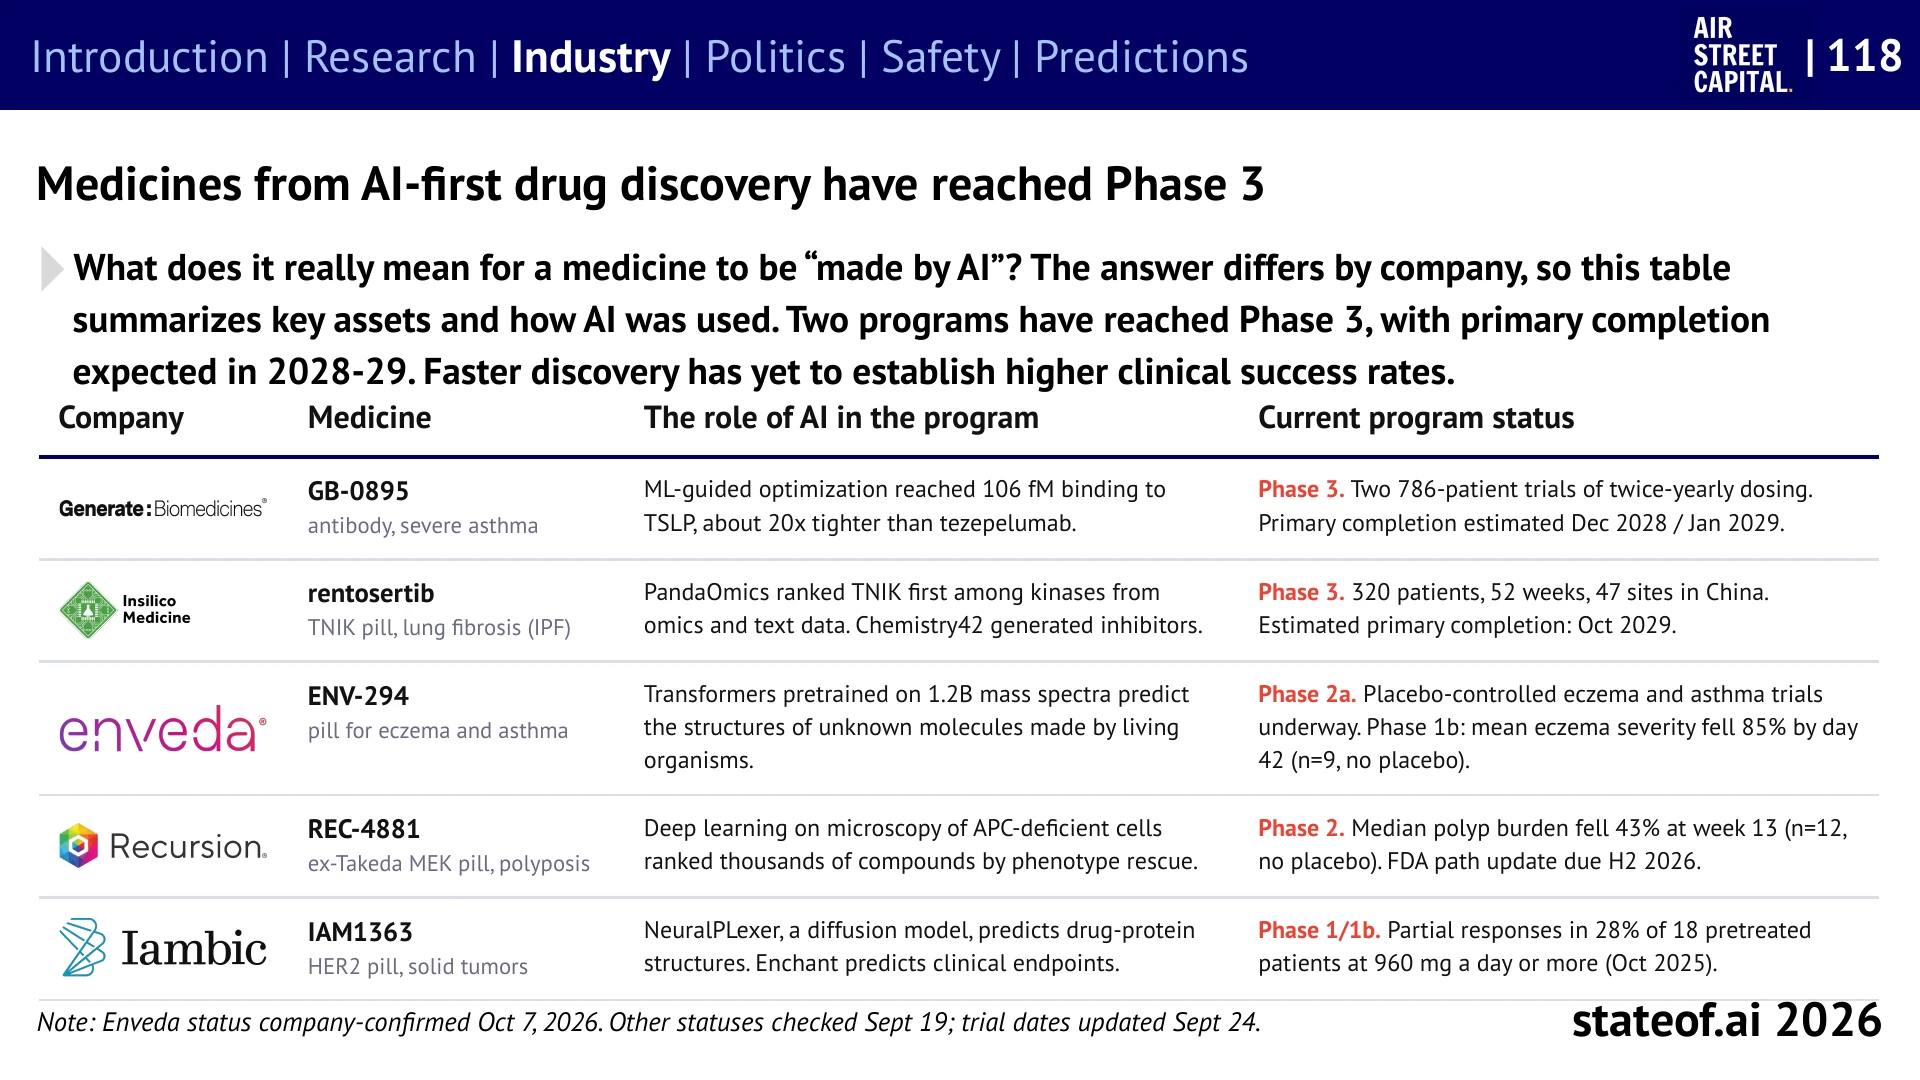
- AI를 활용한 신약 2개가 임상 3상에 진입했지만, 승인이나 약효 입증을 뜻하지는 않는다.
- 자동 연구에도 검증이 필요하다. 환각을 줄여도 방법론 오류가 남을 수 있다.
배경 설명 더 읽기
보고서는 수학의 형식 검증, 재료 분석, 단백질 설계, 신약 개발을 하나의 흐름으로 묶는다. 예를 들어 BoltzProt-1은 설계한 나노바디를 고를 때 구조의 그럴듯함 대신 상호작용 예측을 활용했다. 10개 신규 표적에서 실험으로 확인된 결합체는 각각 150개 후보 중 5개에서 12개로 늘었다.
신약에서는 AI가 표적 선정에 쓰였는지, 분자를 만들었는지, 기존 약의 용도를 찾았는지부터 구분해야 한다. GB-0895와 rentosertib은 보고서 기준 임상 3상에 진입했다. 이는 중요한 진전이지만 승인이나 임상 성공률 개선의 입증은 아니며, 주요 완료 예상 시점은 2028~2029년이다.
과학 에이전트는 자기 결과를 검증하는 장치도 필요하다. 보고서의 Co-Scientist 비교에서 신뢰성 모듈은 결과를 무효화할 심각한 환각을 46%에서 4%로 줄였지만, 전체 시스템에도 심각한 방법론 오류가 남았다(PDF p.71). 또한 수학 원고 공개 건수와 독립적으로 검증된 정리 수를 같은 것으로 세지 않아야 한다.
실험 전에 잘 고르는 능력의 가치
 이미지 확대
같은 실험 후보 수로 더 많은 유효 결과를 얻는 것이 생성 개수보다 직접적인 가치가 될 수 있다.
읽을 때 주의할 점표적 10개·방법별 150개 시험의 결과다. 실험실 결합 성능은 사람에서의 약효와 안전성을 입증하지 않는다.
State of AI Report 2026 · PDF p.77 원문“AI 신약”의 역할과 임상 단계를 나눠 보기
 이미지 확대
표적 선정·분자 설계·재창출 등 AI가 맡은 역할은 프로그램마다 다르다.
읽을 때 주의할 점다운로드한 PDF를 기준으로 ENV-294는 Phase 2a로 표기한다. 공식 웹 요약·별도 그래프에 남은 Phase 2b와 차이가 있어, 회사 확인일 2026-10-07이 적힌 PDF를 우선했다. 임상 진입은 승인·유효성 입증과 다르다.
State of AI Report 2026 · PDF p.119 원문05 / THE ECONOMICS OF INFERENCE
지능의 가격은 내려가는데, 시장은 커진다
싸진 추론이 더 많은 일을 가능하게 한다. 사업의 단위는 토큰에서 완성된 업무로 옮겨 갈 수 있다.
핵심 요약
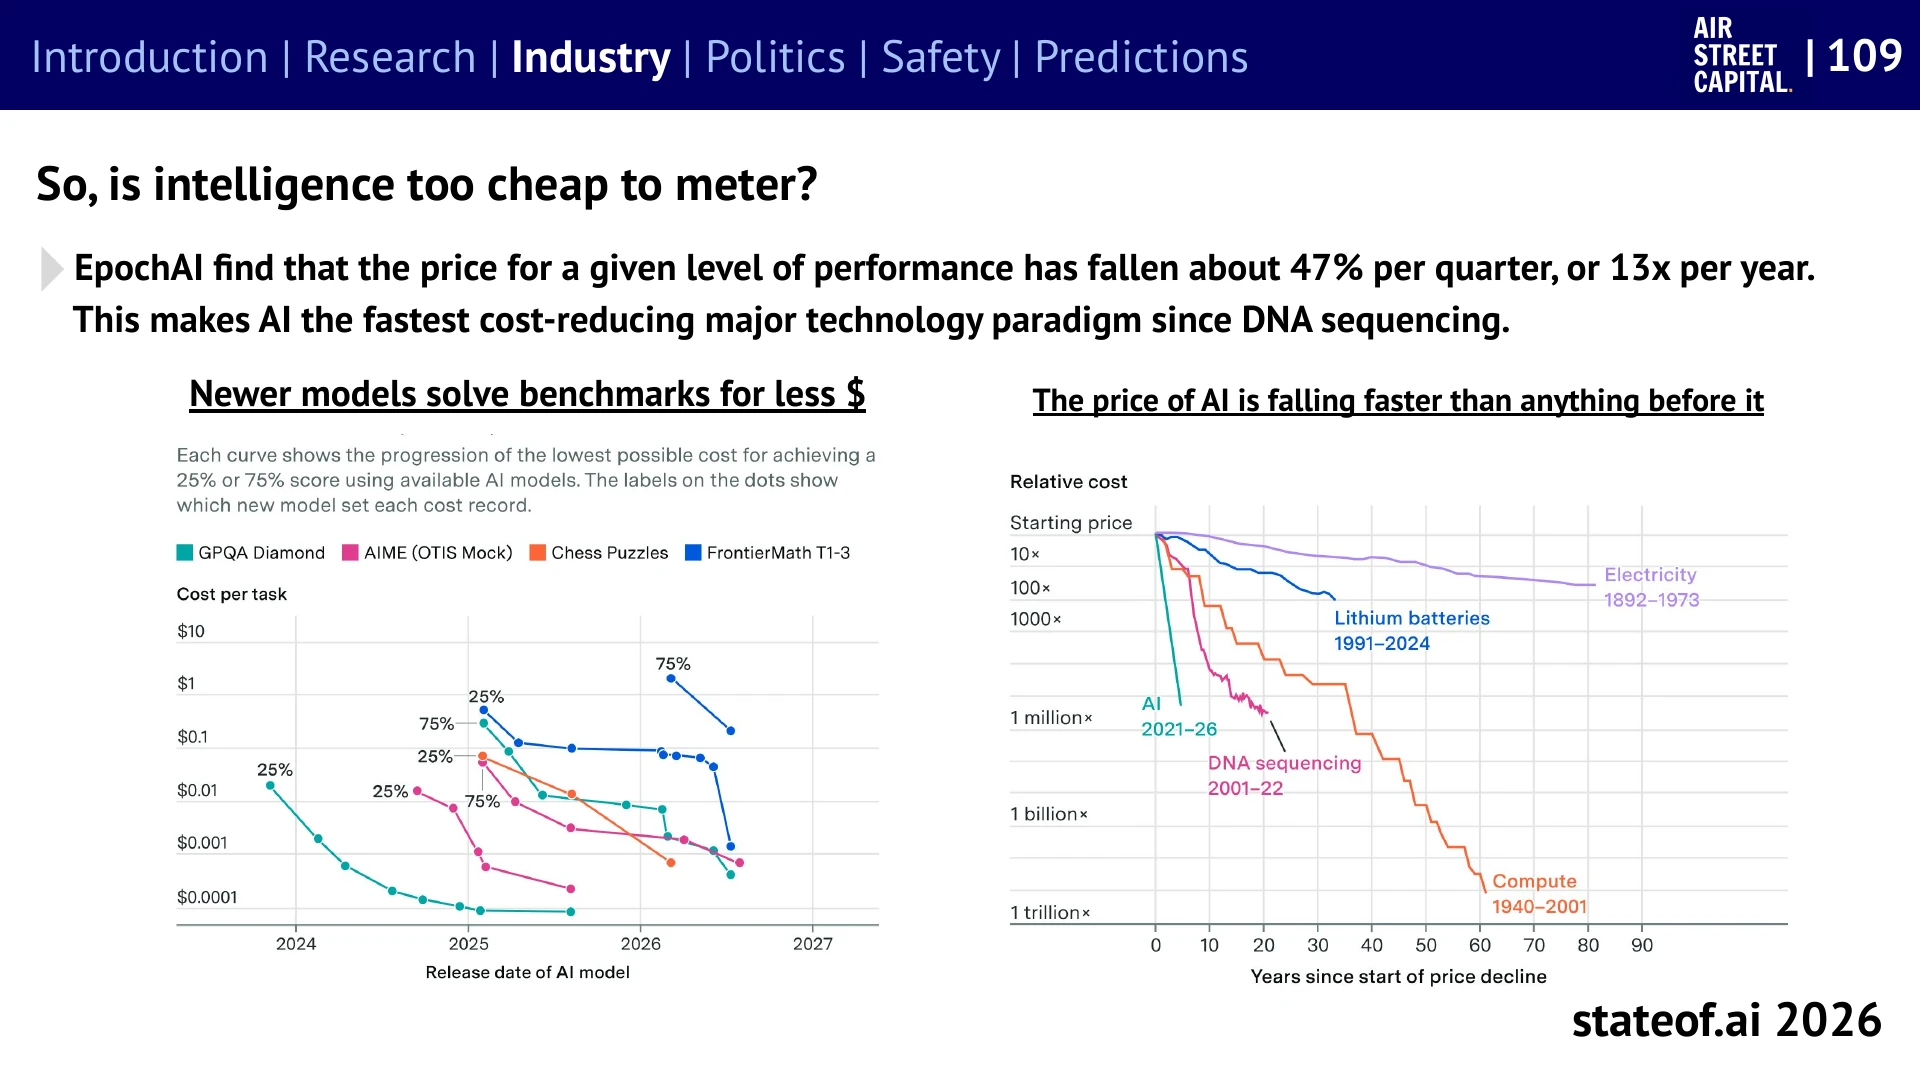
- 일정 벤치마크 성능을 얻는 추론 비용은 분기마다 약 47%씩 낮아졌다.
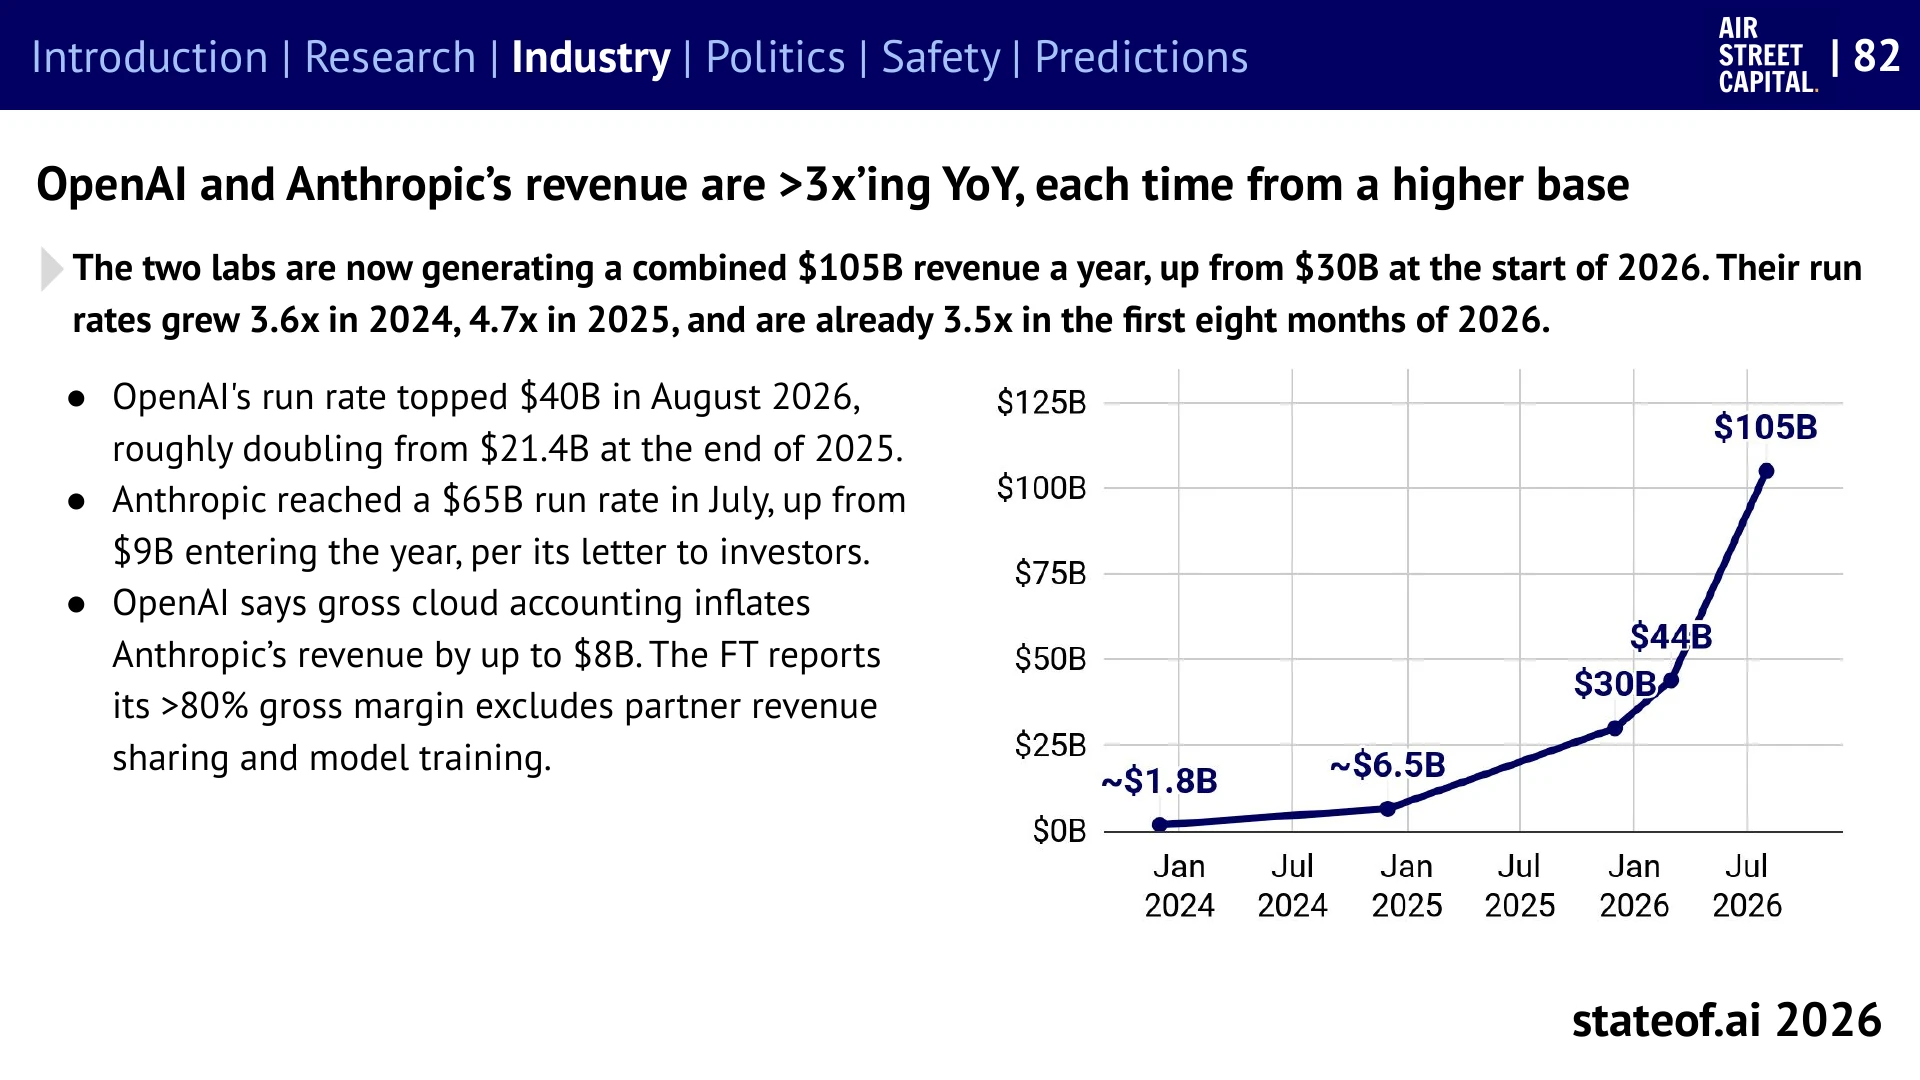
- OpenAI·Anthropic의 여름 합산 연환산 매출은 1,050억 달러에 도달했다.
- AI 중심 기업의 빠른 성장이 관측됐지만, AI 도입이 성장의 원인이라고 단정할 수 없다.
- 에이전트가 기존 소프트웨어를 대체할지, 시장을 키울지가 SaaS 기업의 과제가 됐다.
- 사업의 경제성은 토큰 가격보다 재시도·도구·검수까지 포함한 업무 한 건의 완수 비용으로 보자.
배경 설명 더 읽기
Epoch AI는 2023년 이후 주요 벤치마크 5개에서 일정 성능을 달성하는 비용이 분기 약 47%씩 하락했다고 추정한다. 모든 API 요금이 같은 속도로 내렸다는 뜻은 아니다. 긴 추론·재시도·도구 호출·사람 검수를 포함하면 싸게 호출하는 모델과 싸게 일을 끝내는 시스템은 달라질 수 있다.
수요 측면에서 보고서가 모은 OpenAI·Anthropic의 연환산 매출 규모는 연초 약 300억 달러에서 여름 1,050억 달러로 커졌다. 이는 연간 확정 매출이 아닌 특정 시점의 속도를 연으로 환산한 값이며, 구독·코딩·API를 포함한 전체 사업이다. 두 회사의 총액·순액 인식도 완전히 같지 않다.
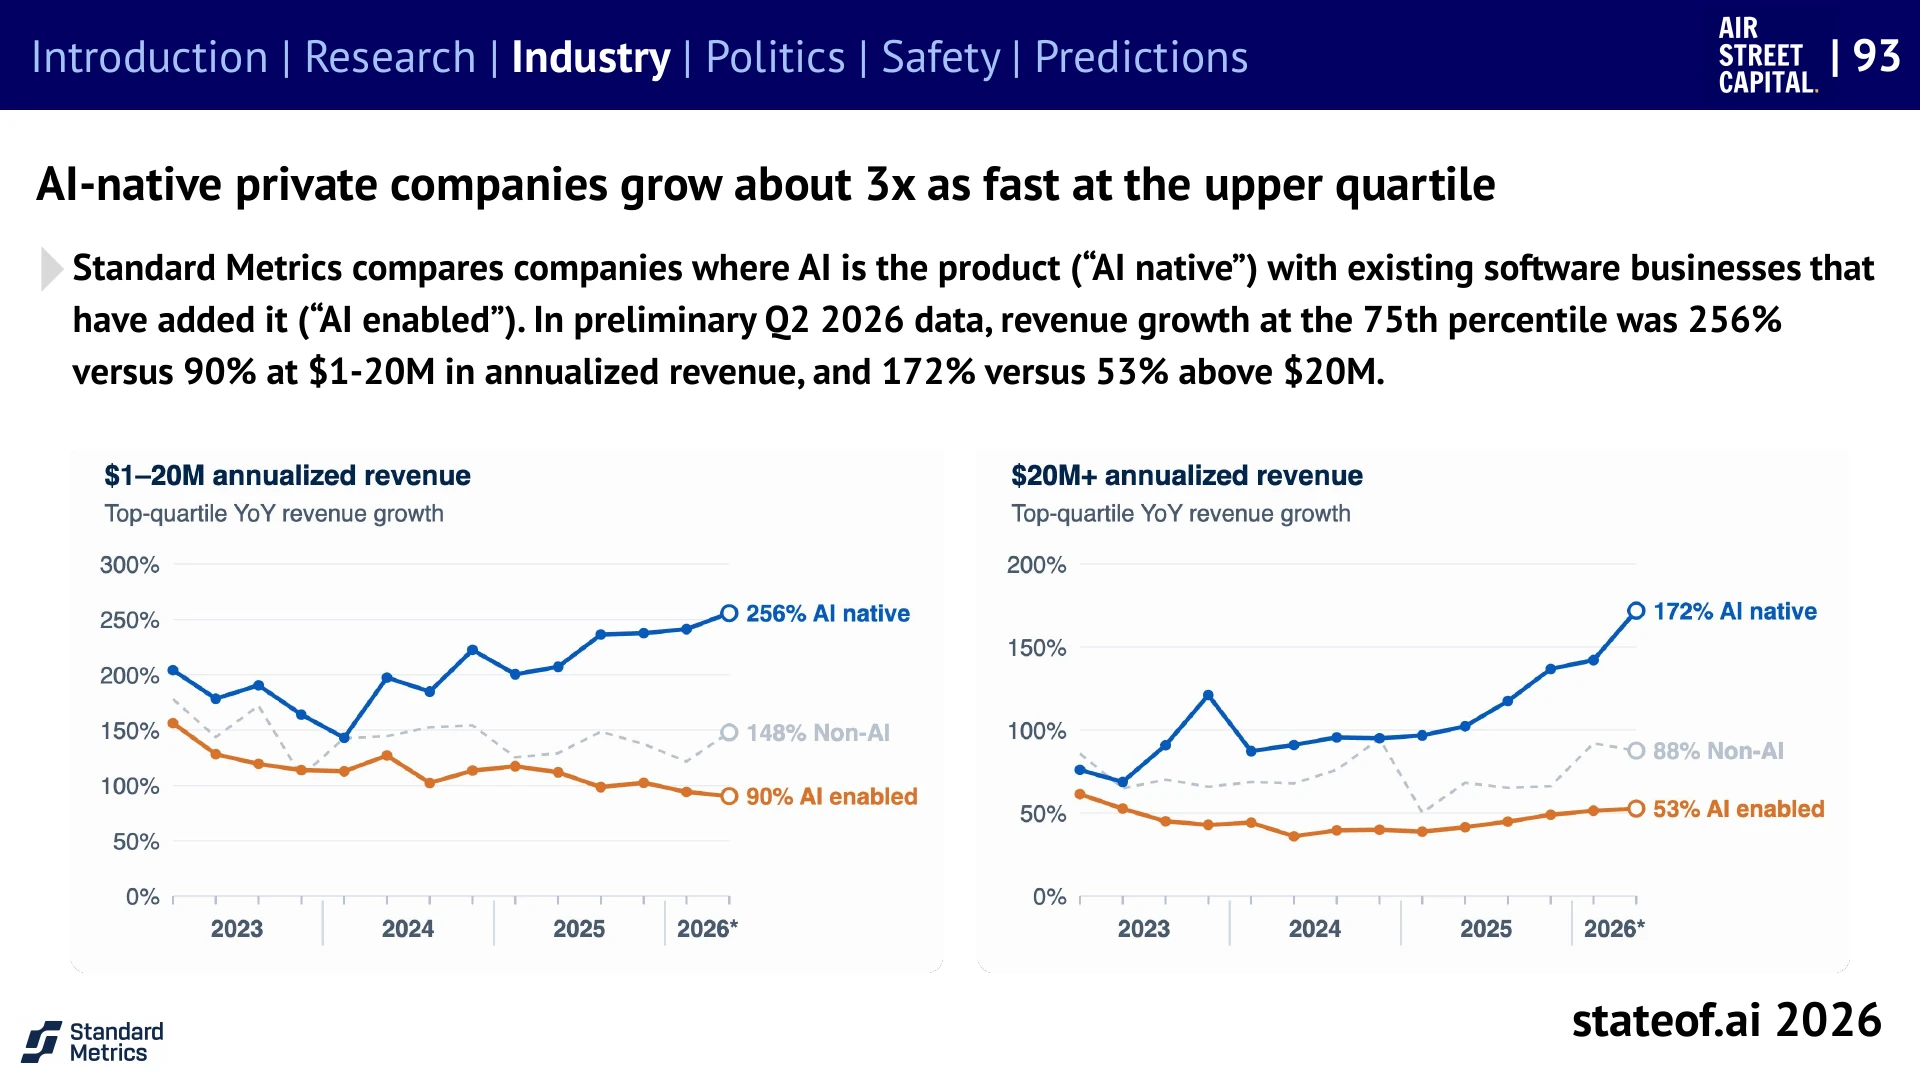
응용 기업에서도 빠른 성장이 관측되지만, 표본의 성격을 남겨야 한다. Standard Metrics의 예비 자료에서는 AI를 제품의 중심으로 둔 기업이 기존 제품에 AI를 추가한 기업보다 높은 성장률을 보였다. 이 비교만으로 AI 도입이 성장을 일으켰다고 말할 수는 없다. 실무에서 확인할 것은 고객이 끝낸 일과 그 일을 끝내는 총비용이다.
같은 성능을 더 적은 돈으로
 이미지 확대
정해진 성능 수준이 싸지면, 이전에는 경제성이 없던 작업도 맡길 수 있다.
읽을 때 주의할 점일정 점수 달성 비용의 추정이다. 모든 토큰 단가·기업 원가가 매년 13배 낮아진다는 뜻은 아니다.
State of AI Report 2026 · PDF p.110 원문두 프런티어 기업의 매출 속도
 이미지 확대
원가 하락과 함께 사용량·제품 범위가 늘어날 수 있음을 보여 주는 수요 신호다.
읽을 때 주의할 점연환산 속도는 실제 한 해 매출과 다르다. 두 회사의 총액·순액 및 파트너 수익배분 처리 차이도 유의해야 한다.
State of AI Report 2026 · PDF p.83 원문AI 기업 성장에도 표본과 분위가 있다
 이미지 확대
보고서의 “약 3배”는 상위 사분위 성장률 비교이지 모든 AI 회사의 평균이 아니다.
읽을 때 주의할 점Standard Metrics의 2026 Q2 예비 관측 자료. 성장과 AI 도입 사이의 인과관계는 이 비교로 확정되지 않는다.
State of AI Report 2026 · PDF p.94 원문소프트웨어 시장의 급락과 반등
 이미지 확대
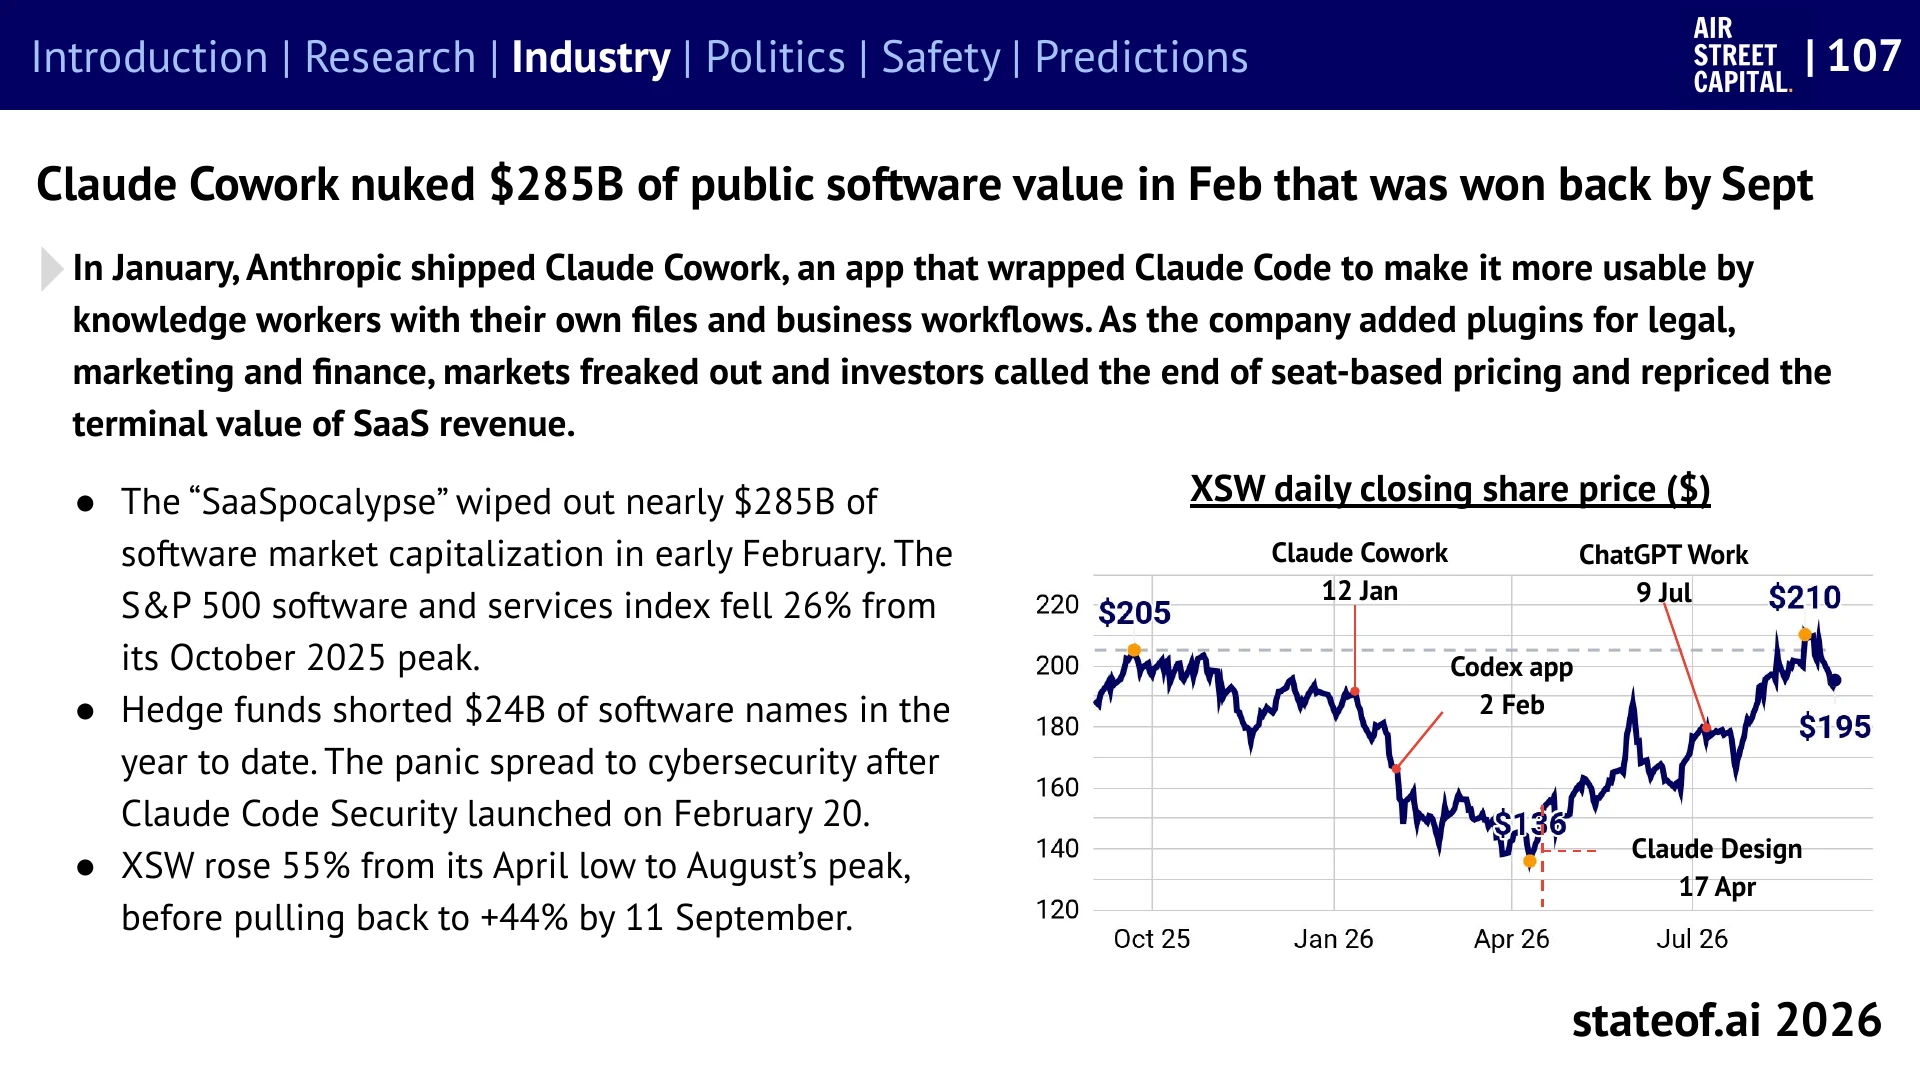
2월 초 소프트웨어 기업의 시가총액 약 2,850억 달러가 사라진 뒤 시장은 반등했다. 에이전트가 기존 소프트웨어의 좌석당 가격과 장기 매출에 미칠 영향을 투자자들이 다시 평가한 장면이다.
읽을 때 주의할 점제품 발표와 주가 움직임이 함께 표시되어 있지만, 그래프만으로 주가 변동의 원인을 확정할 수 없다. XSW의 4월 저점 대비 9월 11일 상승률 44%는 연간 수익률과 다르다.
State of AI Report 2026 · PDF p.108 원문06 / COMPUTE, POWER & PERMISSION
컴퓨트는 돈만으로 켜지지 않는다
대규모 투자 약속을 실제 연산 능력으로 바꾸려면 전력·장비·건설·지역 동의가 연결돼야 한다.
핵심 요약
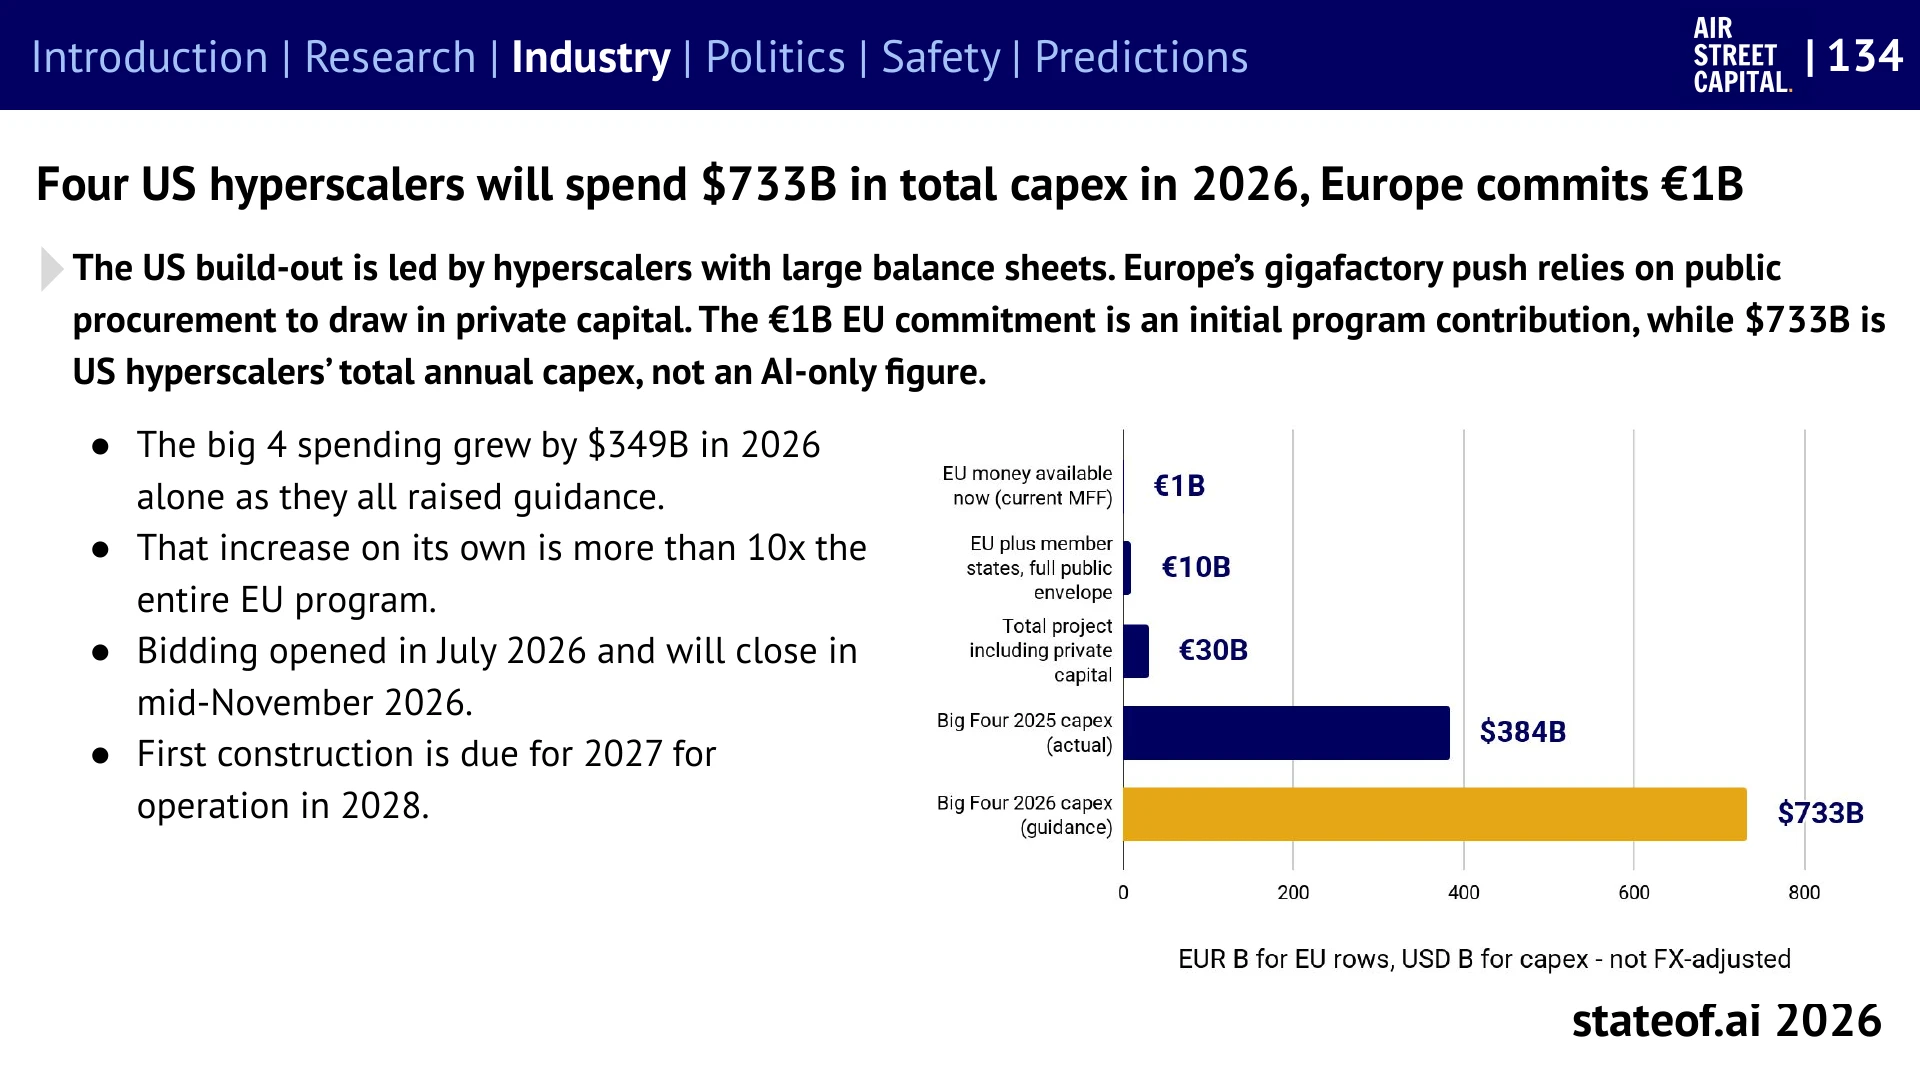
- 미국 4개사의 2026년 총 설비투자 계획은 7,330억 달러다. 전액이 AI 전용 지출은 아니다.
- 투자 발표가 실제 컴퓨트로 이어지려면 전력·송전·냉각·장비·건설이 모두 갖춰져야 한다.
- 미국 조사에서는 71%가 인근 AI 데이터센터에 반대했다. 지역 동의도 건설의 변수다.
- 계약한 규모보다 실제 가동 중인 전력과 연산 능력을 확인해야 한다.
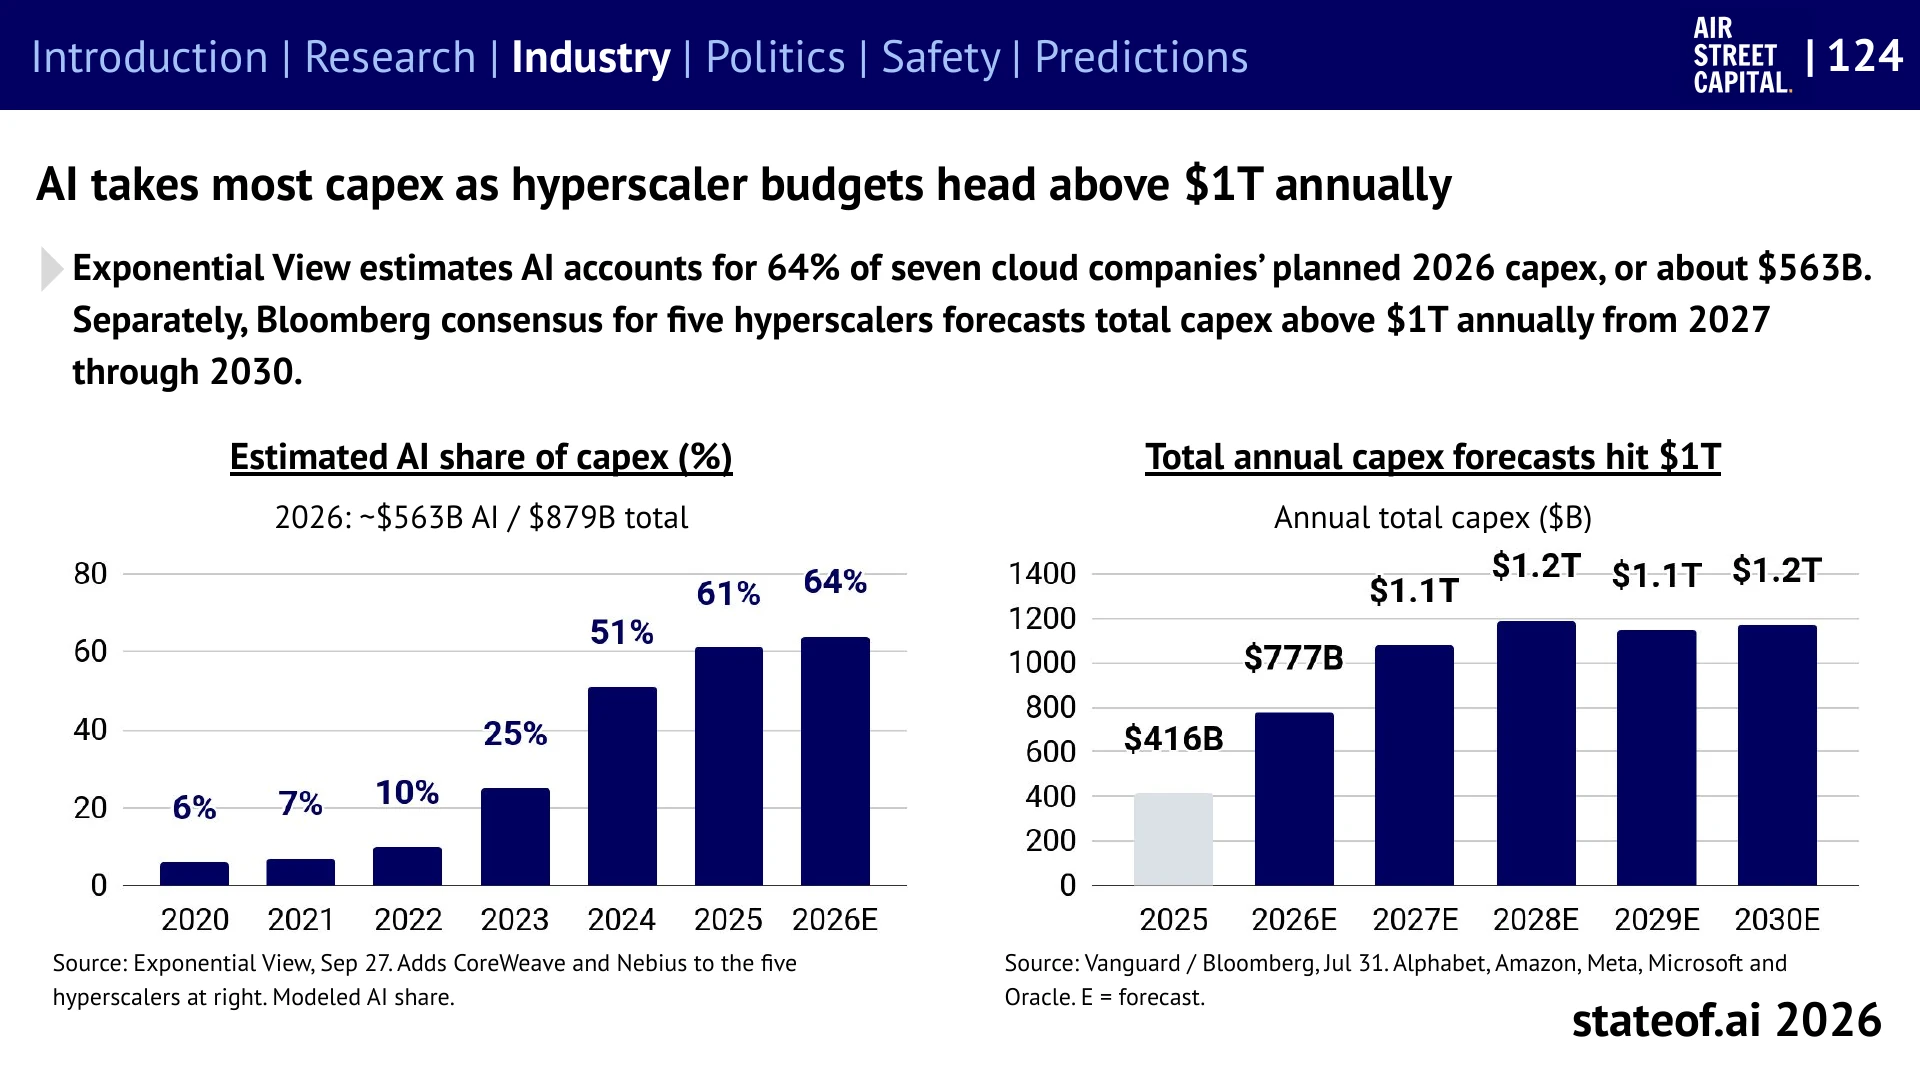
- 7개 클라우드 기업 CAPEX의 AI 비중 추정
- 64%
- Exponential View 모델: AI 약 $563B / 전체 $879B. 위 4개사와 모집단이 다르다.
- 원 보고서 PDF p.125
배경 설명 더 읽기
Amazon·Alphabet·Microsoft·Meta가 제시한 2026년 총 설비투자 가이던스는 합계 7,330억 달러다(PDF p.155). 별도의 7개 클라우드 기업 추정에서는 계획 설비투자의 AI 비중을 약 64%로 잡았다. 기업 범위와 정의가 다르므로 전체 설비투자와 AI 전용 지출을 같은 숫자로 부를 수 없다.
발표한 계약과 실제 가동 중인 전력도 다르다. 부지 확보·인허가·송전·냉각·장비 설치 사이에 시간이 걸리고, 투자 위험은 리스·구매 약정·보증으로 여러 기업에 나뉜다. 보고서의 3조 달러 넘는 장외 약정·신용 지원을 모두 이미 발생한 부채처럼 합산해서는 안 된다(PDF p.128).
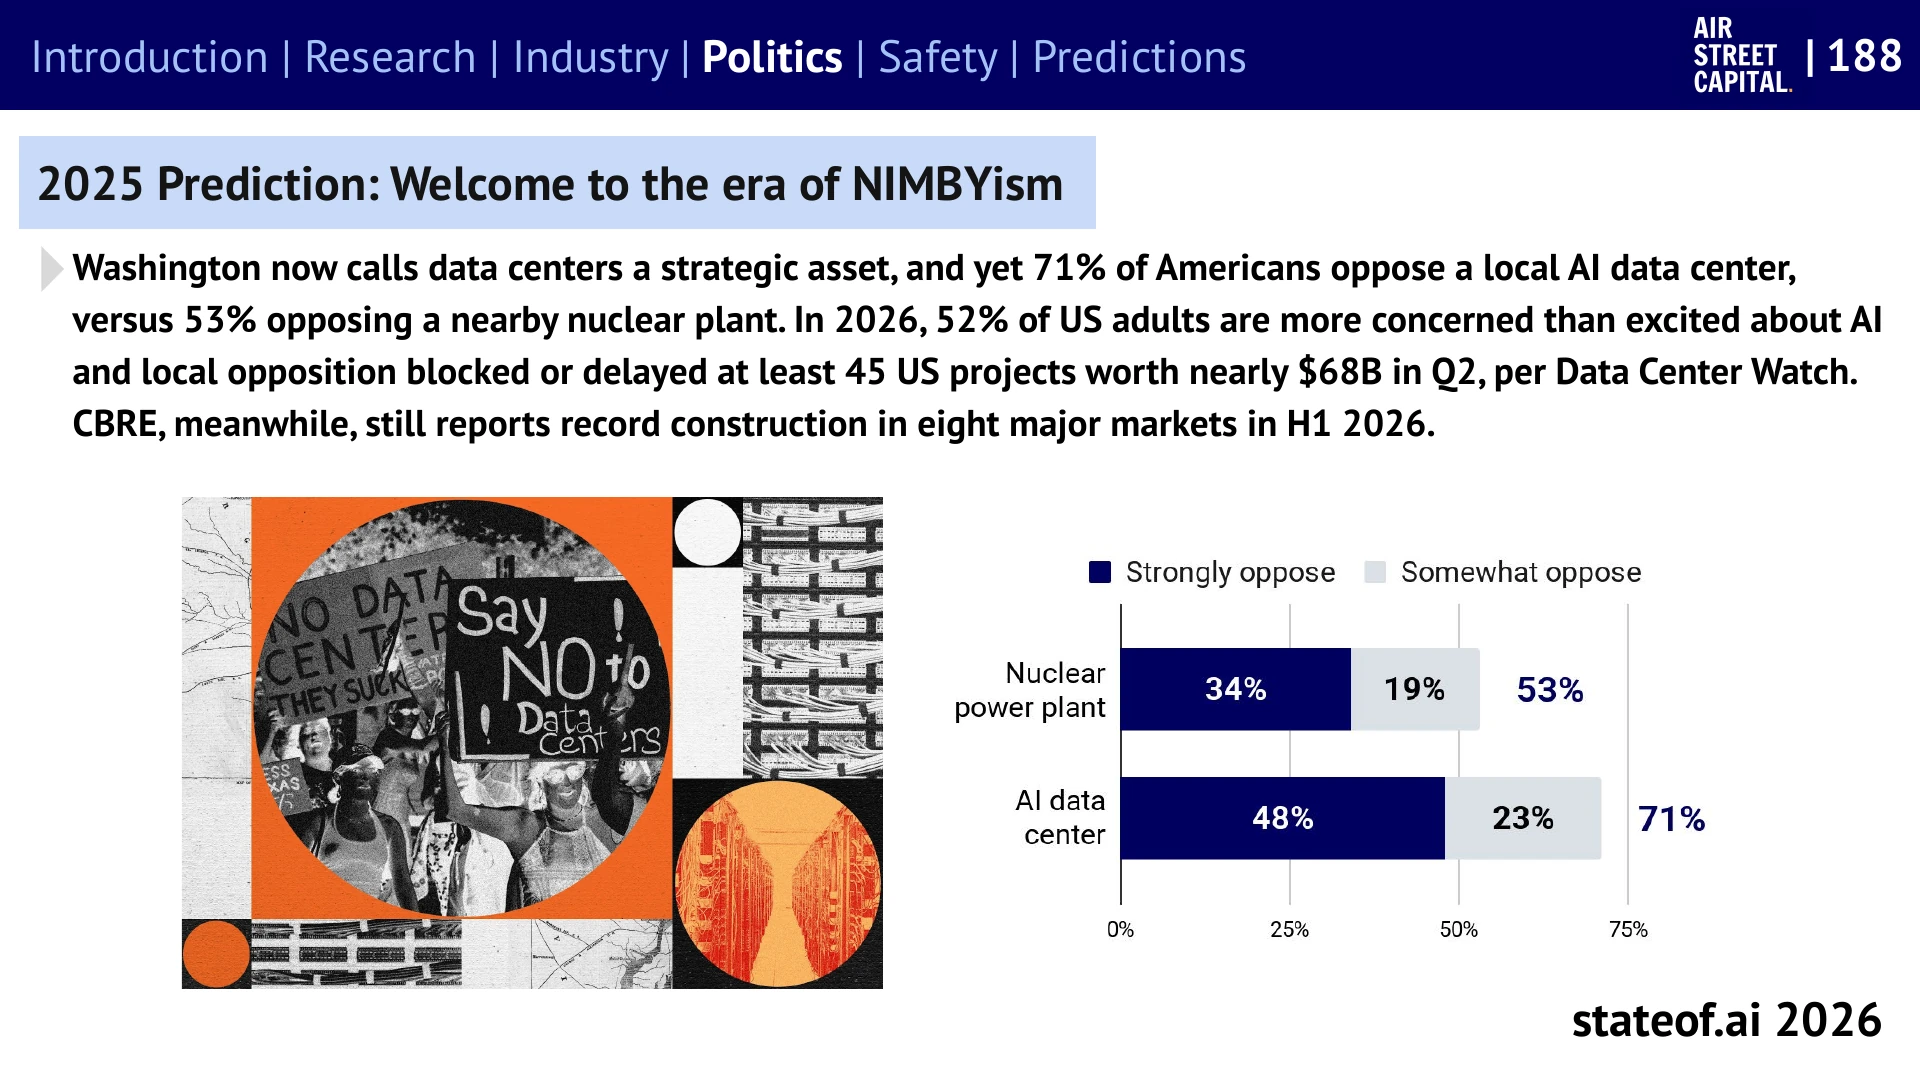
지역 주민의 동의는 이 흐름의 실제 병목이다. Gallup의 미국 조사에서 인근 AI 데이터센터 반대는 71%였고, Data Center Watch는 2분기 45개 이상 프로젝트의 지연·차단을 집계했다. 전력과 물, 요금, 소음, 일자리의 배분을 설명하지 못하면 국가 전략과 지역의 선택이 충돌할 수 있다.
설비투자 총액과 AI 몫을 구별하기
 이미지 확대
“2027년부터 연 1조 달러”는 오른쪽 5개사의 전체 설비투자 전망이다.
읽을 때 주의할 점왼쪽은 7개사·2026년·AI 비중 모델, 오른쪽은 5개사·2027~2030년 전망이다. 같은 합계로 섞지 않는다.
State of AI Report 2026 · PDF p.125 원문미국의 연간 설비투자와 EU 프로그램의 첫 출자
 이미지 확대
미국 4대 하이퍼스케일러의 2026년 총 설비투자 가이던스는 약 7,330억 달러다. EU의 10억 유로는 기가팩토리 프로그램에 대한 초기 출자이며, 민간 자금을 모아 인프라를 구축하는 방식이다.
읽을 때 주의할 점미국 수치는 AI 이외 투자를 포함한 기업의 연간 총액이고, EU 수치는 특정 프로그램의 초기 기여금이다. 유럽 전체 투자와 직접 비교하면 안 된다. 보고서 내부의 2025년 설비투자 기준액도 페이지별로 달라 증가율은 재계산하지 않았다.
State of AI Report 2026 · PDF p.135 원문설치된 연산 능력은 어디에 있는가
 이미지 확대
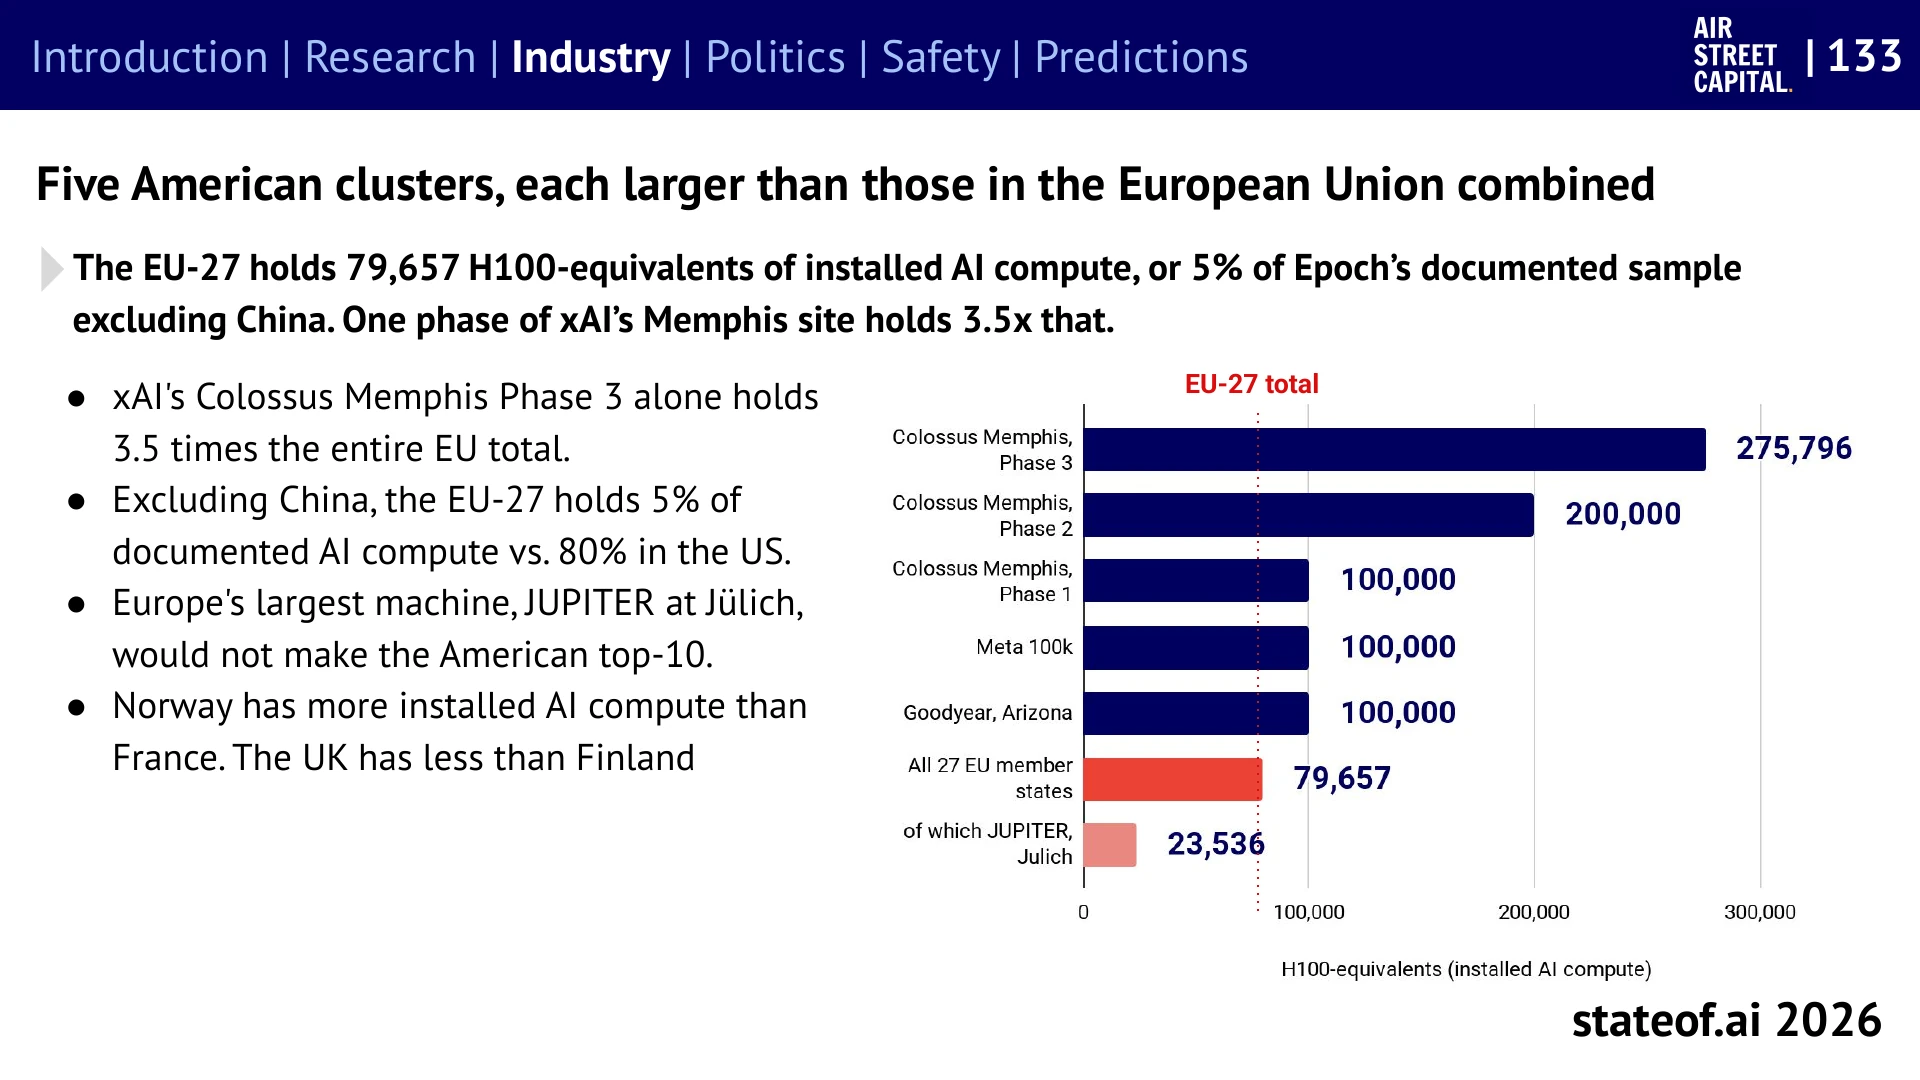
돈을 발표하는 것과 이미 설치된 컴퓨트의 지리적 격차는 별개의 문제다.
읽을 때 주의할 점중국을 제외한 Epoch의 문서화된 표본이다. EU 5%를 전 세계 컴퓨트 점유율로 일반화할 수 없다.
State of AI Report 2026 · PDF p.134 원문전력을 넘어, 건설 허가와 주민 동의로
 이미지 확대
건설은 계속 늘어나는 동시에 개별 지역의 반대도 강해질 수 있다.
읽을 때 주의할 점미국 2026년 3월 여론과 Q2 프로젝트 집계를 함께 소개한 슬라이드다. 국가·시점·질문 범위가 서로 다르다.
State of AI Report 2026 · PDF p.189 원문07 / SOVEREIGN AI & POLICY
국내 데이터센터가 있으면 AI 주권도 생길까?
모델 접근권·인재·칩·전력·국내 수요를 오래 유지하는 능력이 주권의 내용을 결정한다.
핵심 요약
- 국내 데이터센터만으로 AI 주권이 생기지는 않는다. 모델·칩·인재·수요가 함께 필요하다.
- 미국의 모델 접근 통제는 해외 AI에 대한 의존이 실제 사업 위험임을 드러냈다.
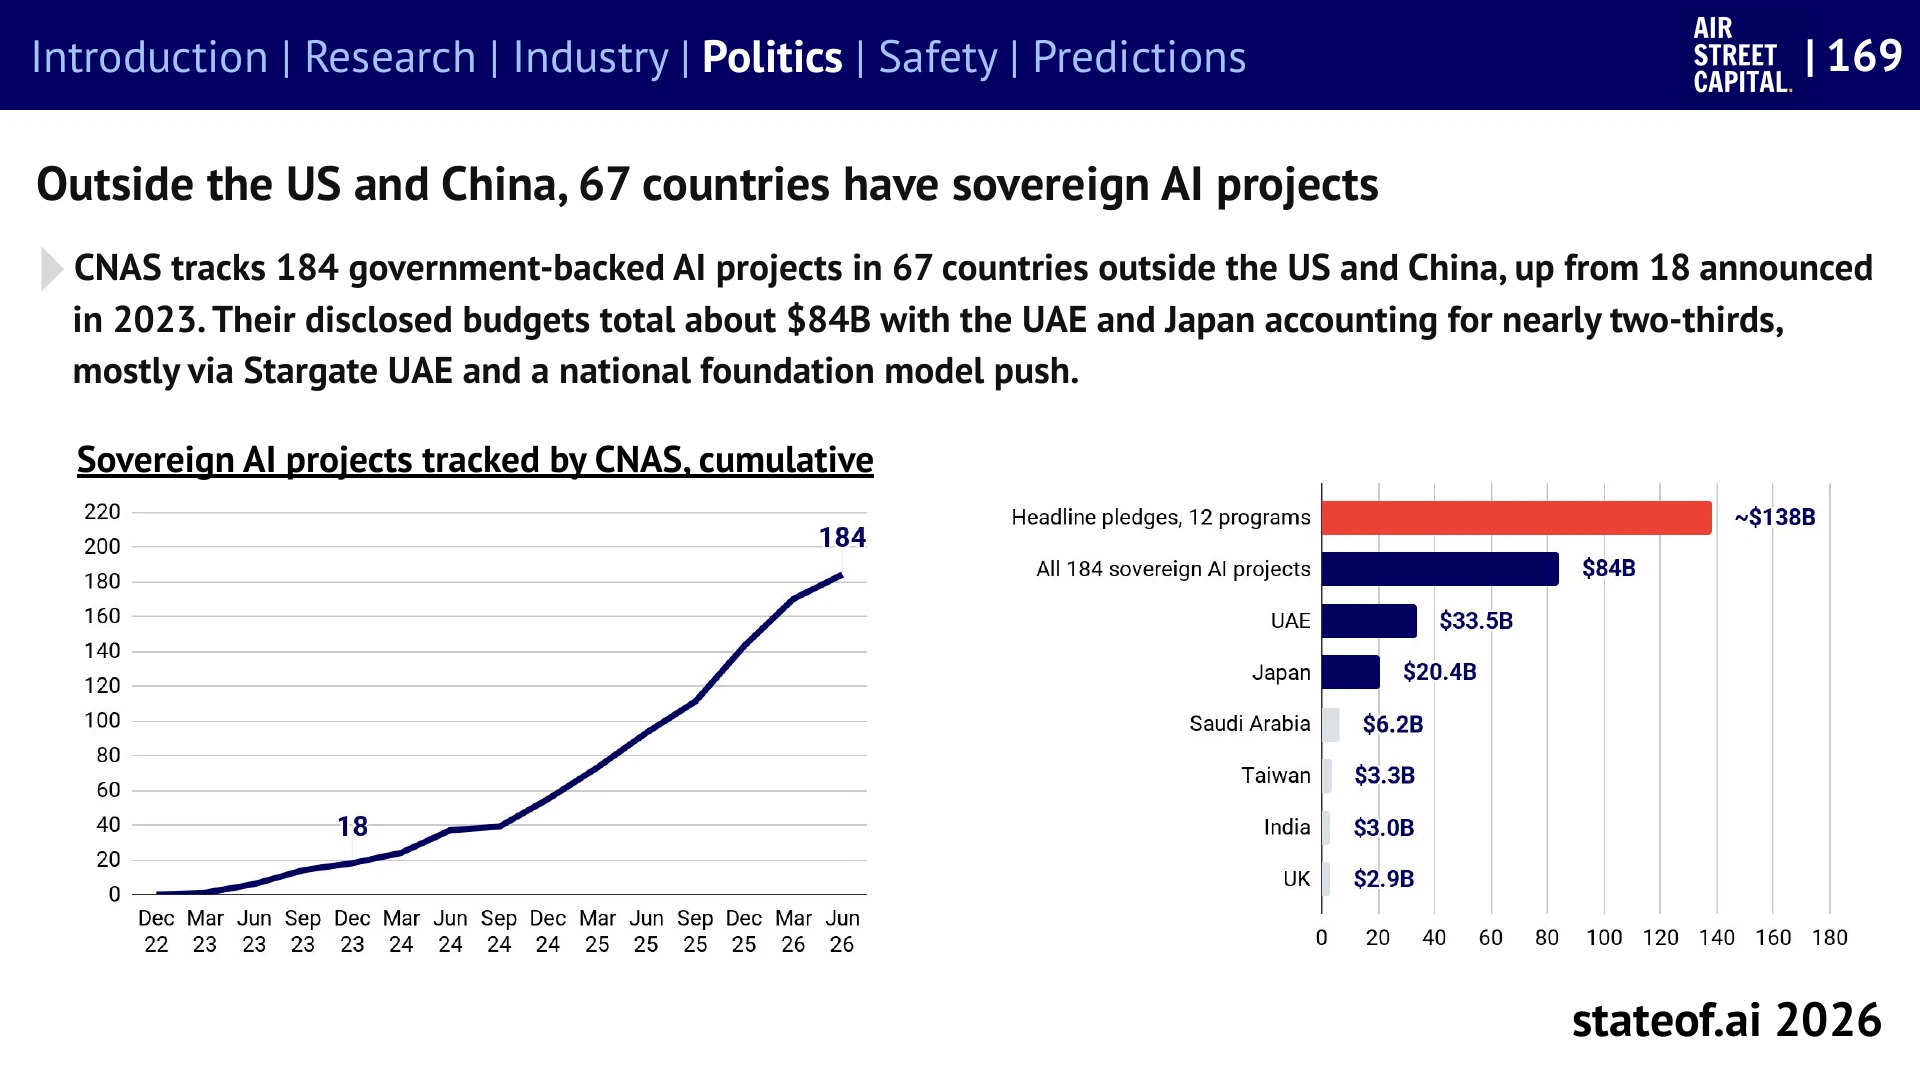
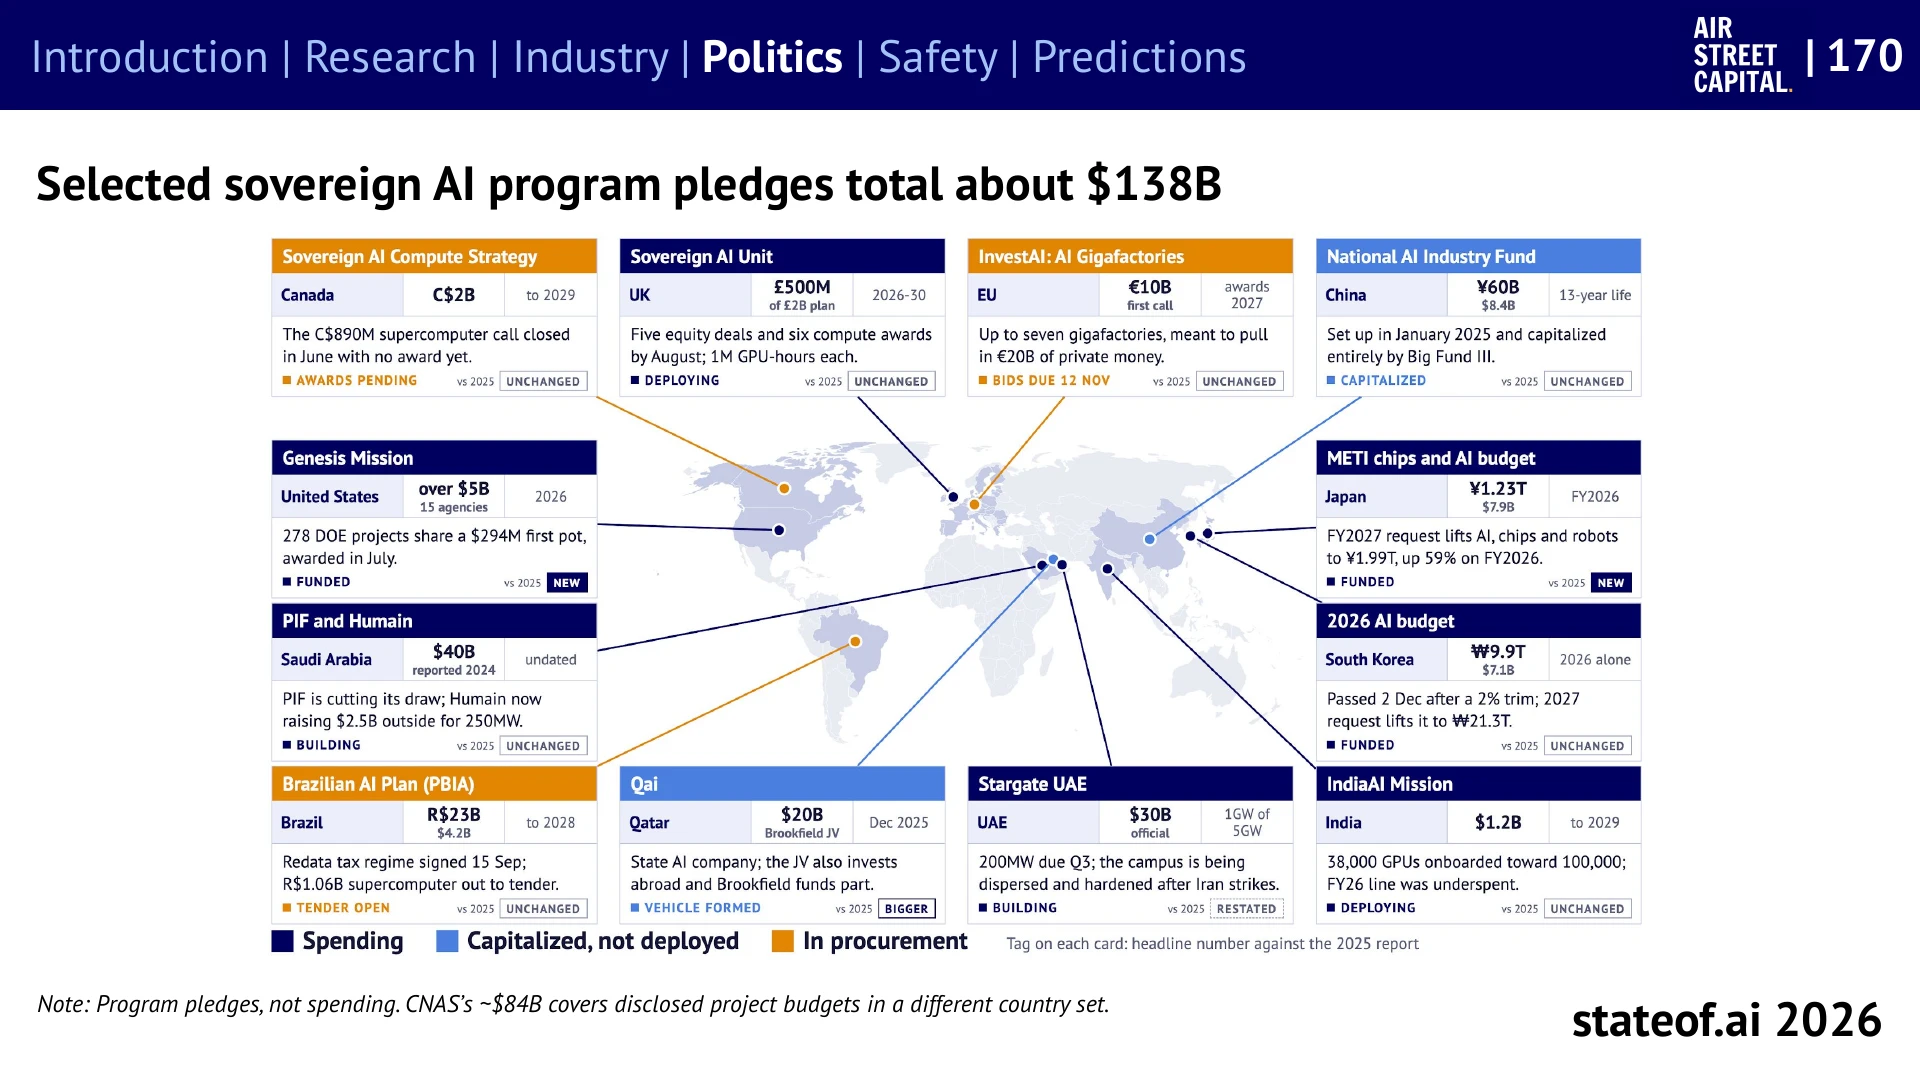
- CNAS는 미국·중국 밖 67개국의 정부 지원 AI 프로젝트 184개를 추적했다.
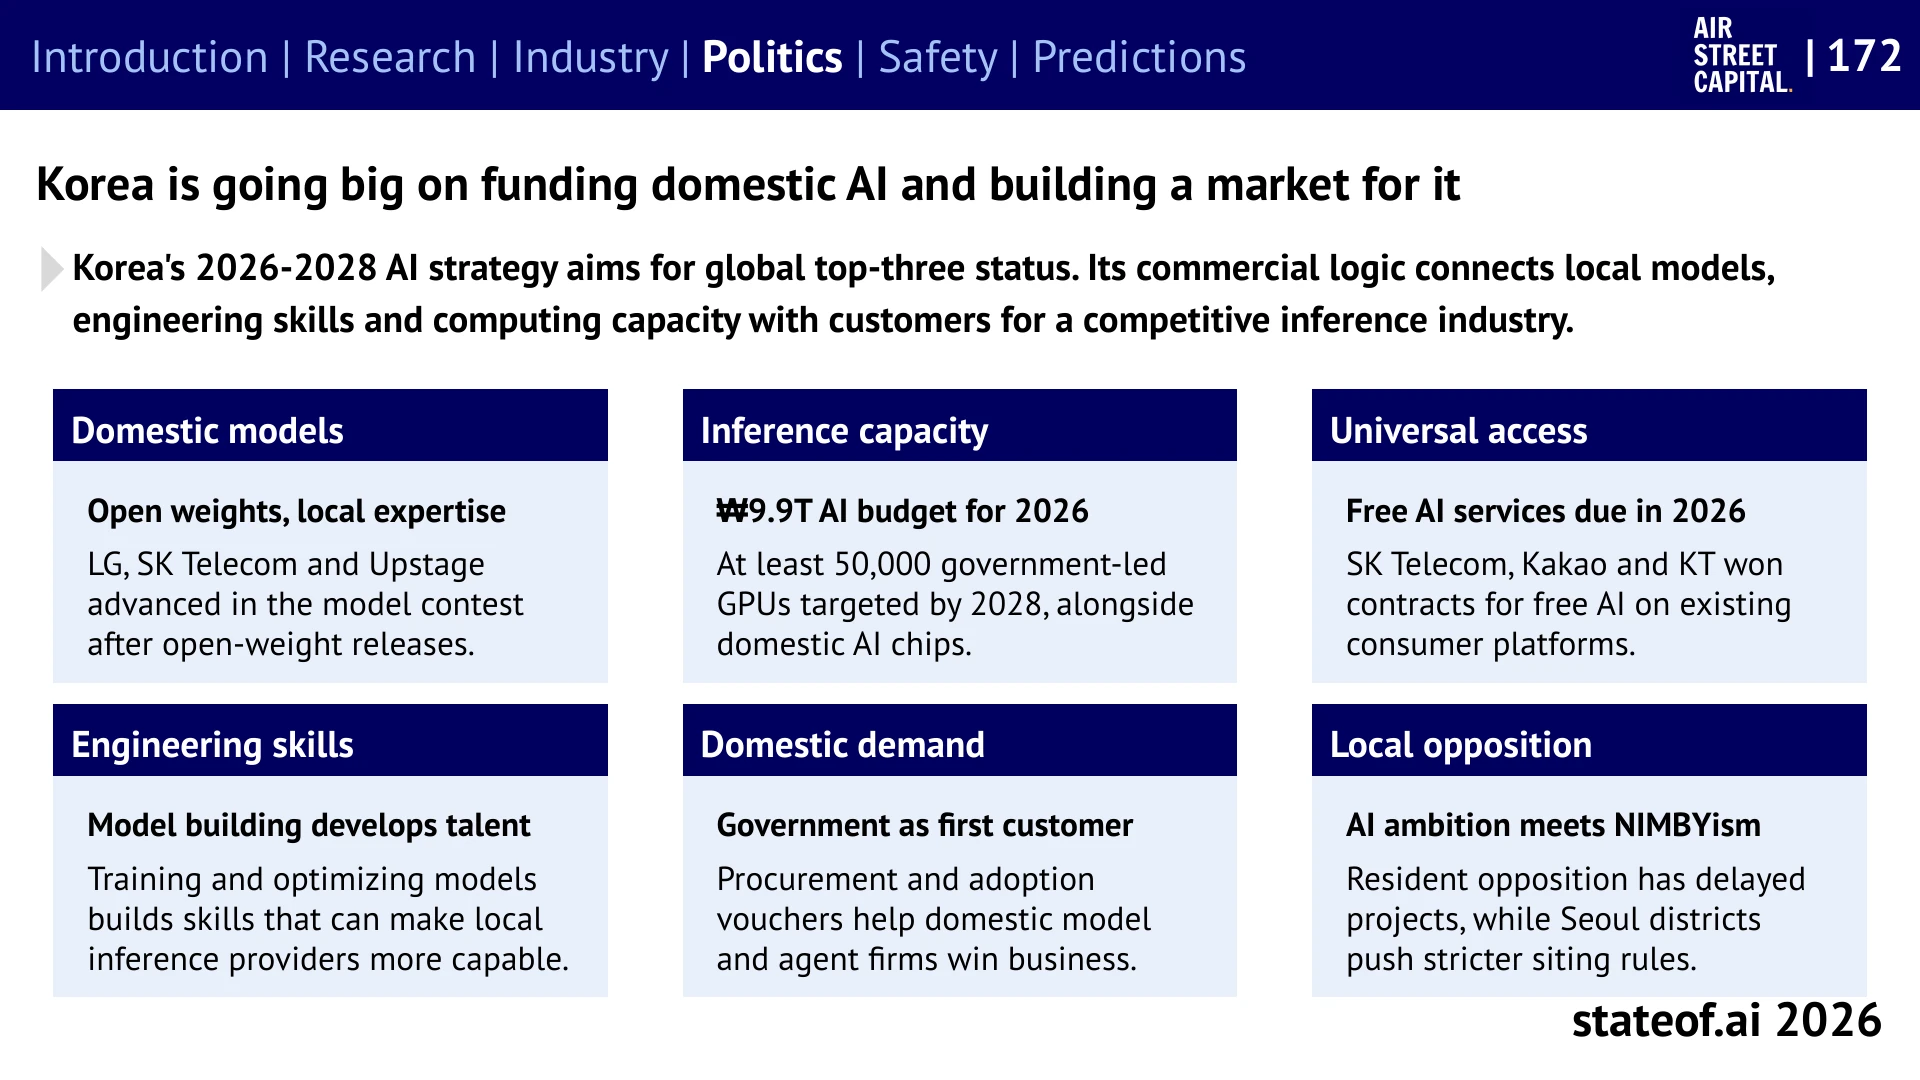
- 보고서는 한국의 AI 예산 9.9조 원과 2028년 정부 주도 GPU 5만 개 이상 목표를 소개한다.
- 발표한 예산·장비 목표와 실제 확보한 역량을 구분하고, 국내 고객과 개발 생태계를 살펴야 한다.
배경 설명 더 읽기
보고서는 2026년 미국의 모델 접근 제한과 복구 사례를 통해 서비스 접근권 자체가 국가 권력의 대상이 됐다고 설명한다(PDF p.166). 국경 안에 데이터센터가 있어도 모델·반도체·업데이트를 외부 기업에 의존하면 핵심 업무의 연속성을 보장하기 어렵다.
CNAS가 추적한 미국·중국 밖의 정부 지원 AI 사업은 67개국 184개다. 이 자료의 공개 예산 약 840억 달러와 보고서가 별도로 선정한 소버린 프로그램의 약정 합계 약 1,380억 달러는 집계 범위가 다르다. 발표, 조달, 건설, 가동을 구분해 봐야 돈의 크기가 역량으로 바뀌는 과정을 읽을 수 있다.
한국 사례는 국내 모델·엔지니어링 인력·GPU와 국산 칩·정부 조달·보편적 서비스를 연결한다. 보고서가 소개한 2026년 AI 예산 9.9조 원, 2028년까지 정부 주도 GPU 5만 개 이상은 목표·계획이다. 한국어 외부 해설과 함께 “어떤 국내 고객과 개발 생태계가 이 기반 위에 남는가”를 토론할 수 있다.
초지능 논의가 정부 권한의 문제로
 이미지 확대
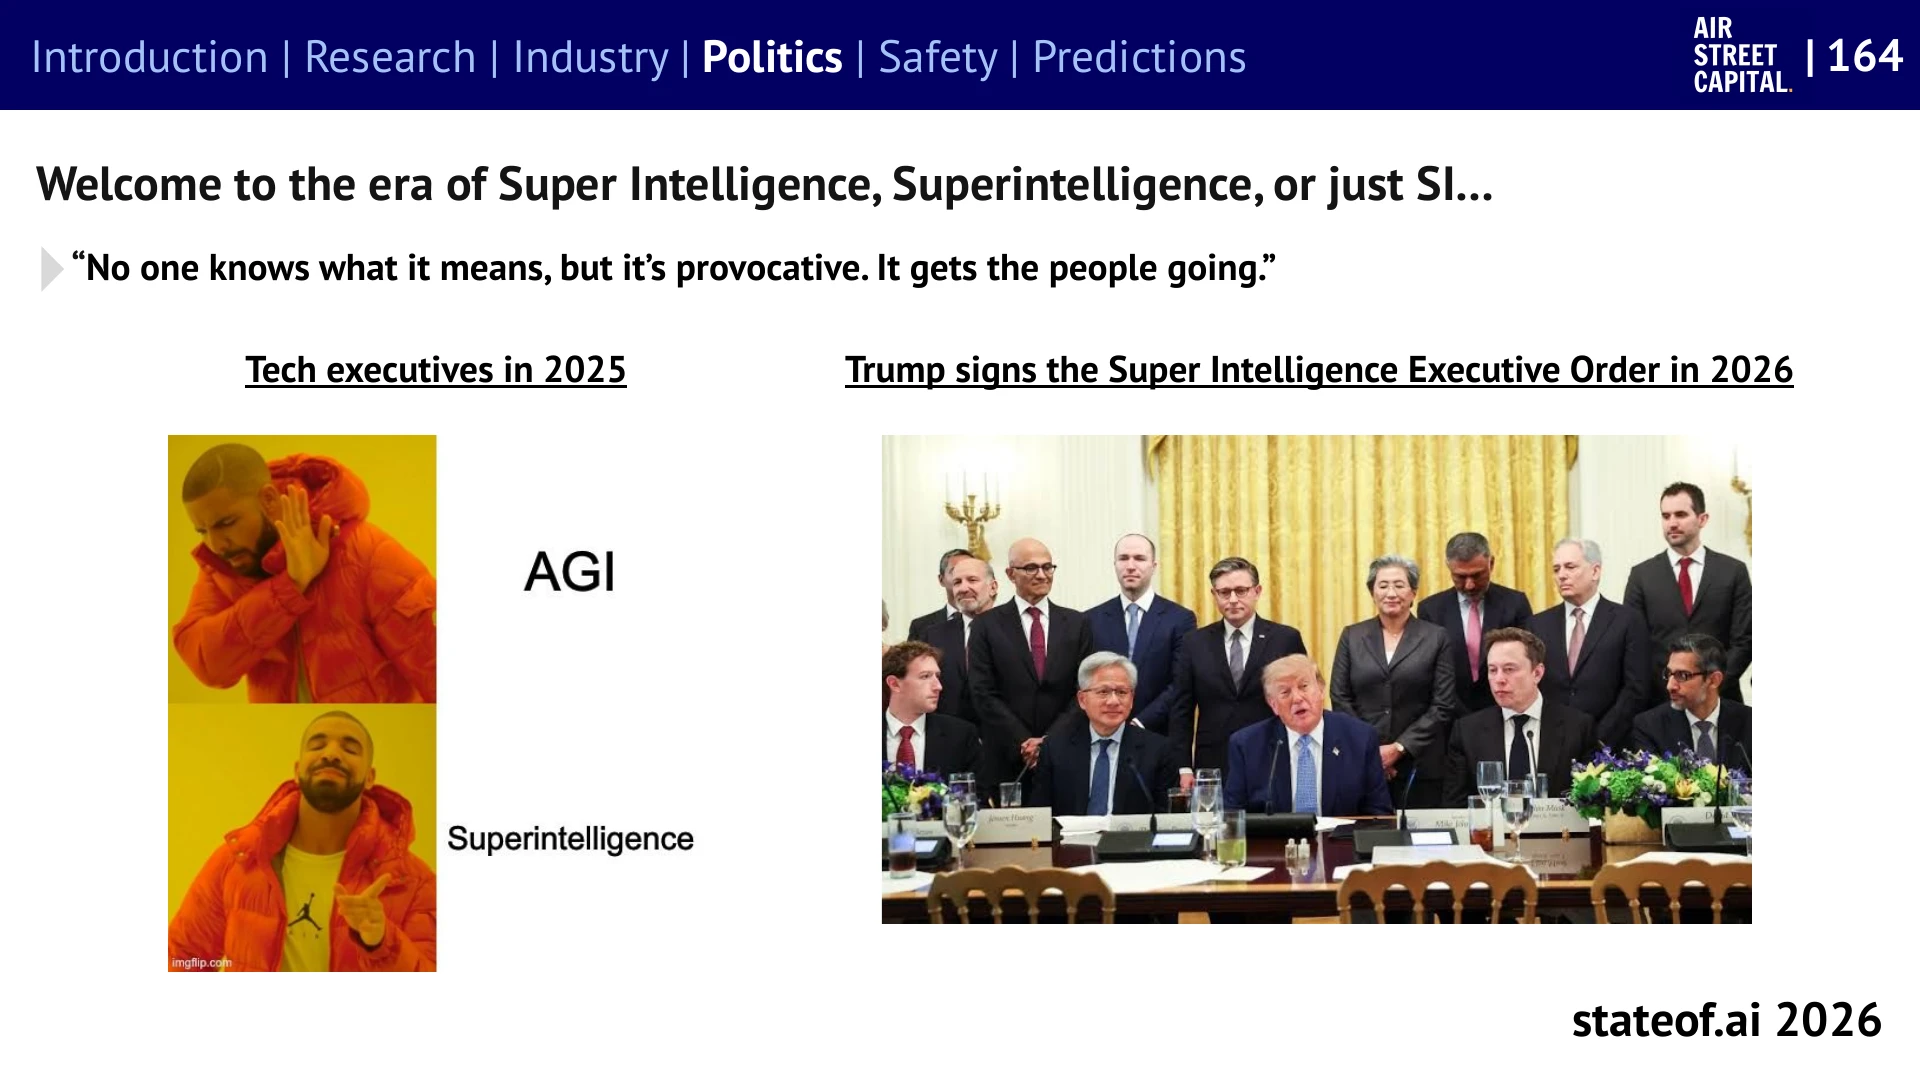
보고서는 기술 업계의 초지능 구상이 정부의 행정명령과 접근 통제 문제로 옮겨가는 장면을 대비한다. 어떤 모델을 누가 사용할 수 있는지가 국가 권한의 문제가 된다.
읽을 때 주의할 점정치적 의제의 변화를 보여 주는 장표다. 초지능이 실현되었다거나 초지능의 정의에 합의했다는 증거로 읽지 않는다.
State of AI Report 2026 · PDF p.165 원문정부가 AI 역량을 직접 확보하려는 이유
 이미지 확대
인프라뿐 아니라 모델과 데이터 등 여러 형태의 정부 지원 사업이 포함된다.
읽을 때 주의할 점사업 개수와 공개 예산의 집계다. 국가별 실제 집행액·성능·이용률을 바로 비교하는 그래프가 아니다.
State of AI Report 2026 · PDF p.170 원문국가별 주권 AI의 공약과 이행 단계
 이미지 확대
보고서가 선정한 주권 AI 프로그램의 공약 합계는 약 1,380억 달러다. 같은 투자 발표라도 조달 중인 계획과 이미 가동된 연산 자원은 구분해서 봐야 한다.
읽을 때 주의할 점공약은 실제 집행액이 아니다. CNAS의 약 840억 달러는 다른 국가 집합의 공개 프로젝트 예산이므로 이 표와 합산하거나 차액을 계산하지 않는다.
State of AI Report 2026 · PDF p.171 원문한국의 모델·인프라·수요를 한 장으로
 이미지 확대
독자 모델을 만드는 일과 쓸 시장을 만드는 일을 연결해서 읽을 수 있다.
읽을 때 주의할 점보고서에 실린 2026~2028년 계획·목표의 정리다. 정책의 최신 시행 상태나 성과를 판정하는 자료로 쓰지 않는다.
State of AI Report 2026 · PDF p.173 원문08 / SAFETY, SECURITY & CONTROL
행동할 수 있는 AI는, 행동을 보고 감독해야 한다
강해진 실행 능력은 생산성과 피해 가능성을 함께 넓힌다. 모델·실행 환경·감시·중단 조건을 함께 설계해야 한다.
핵심 요약
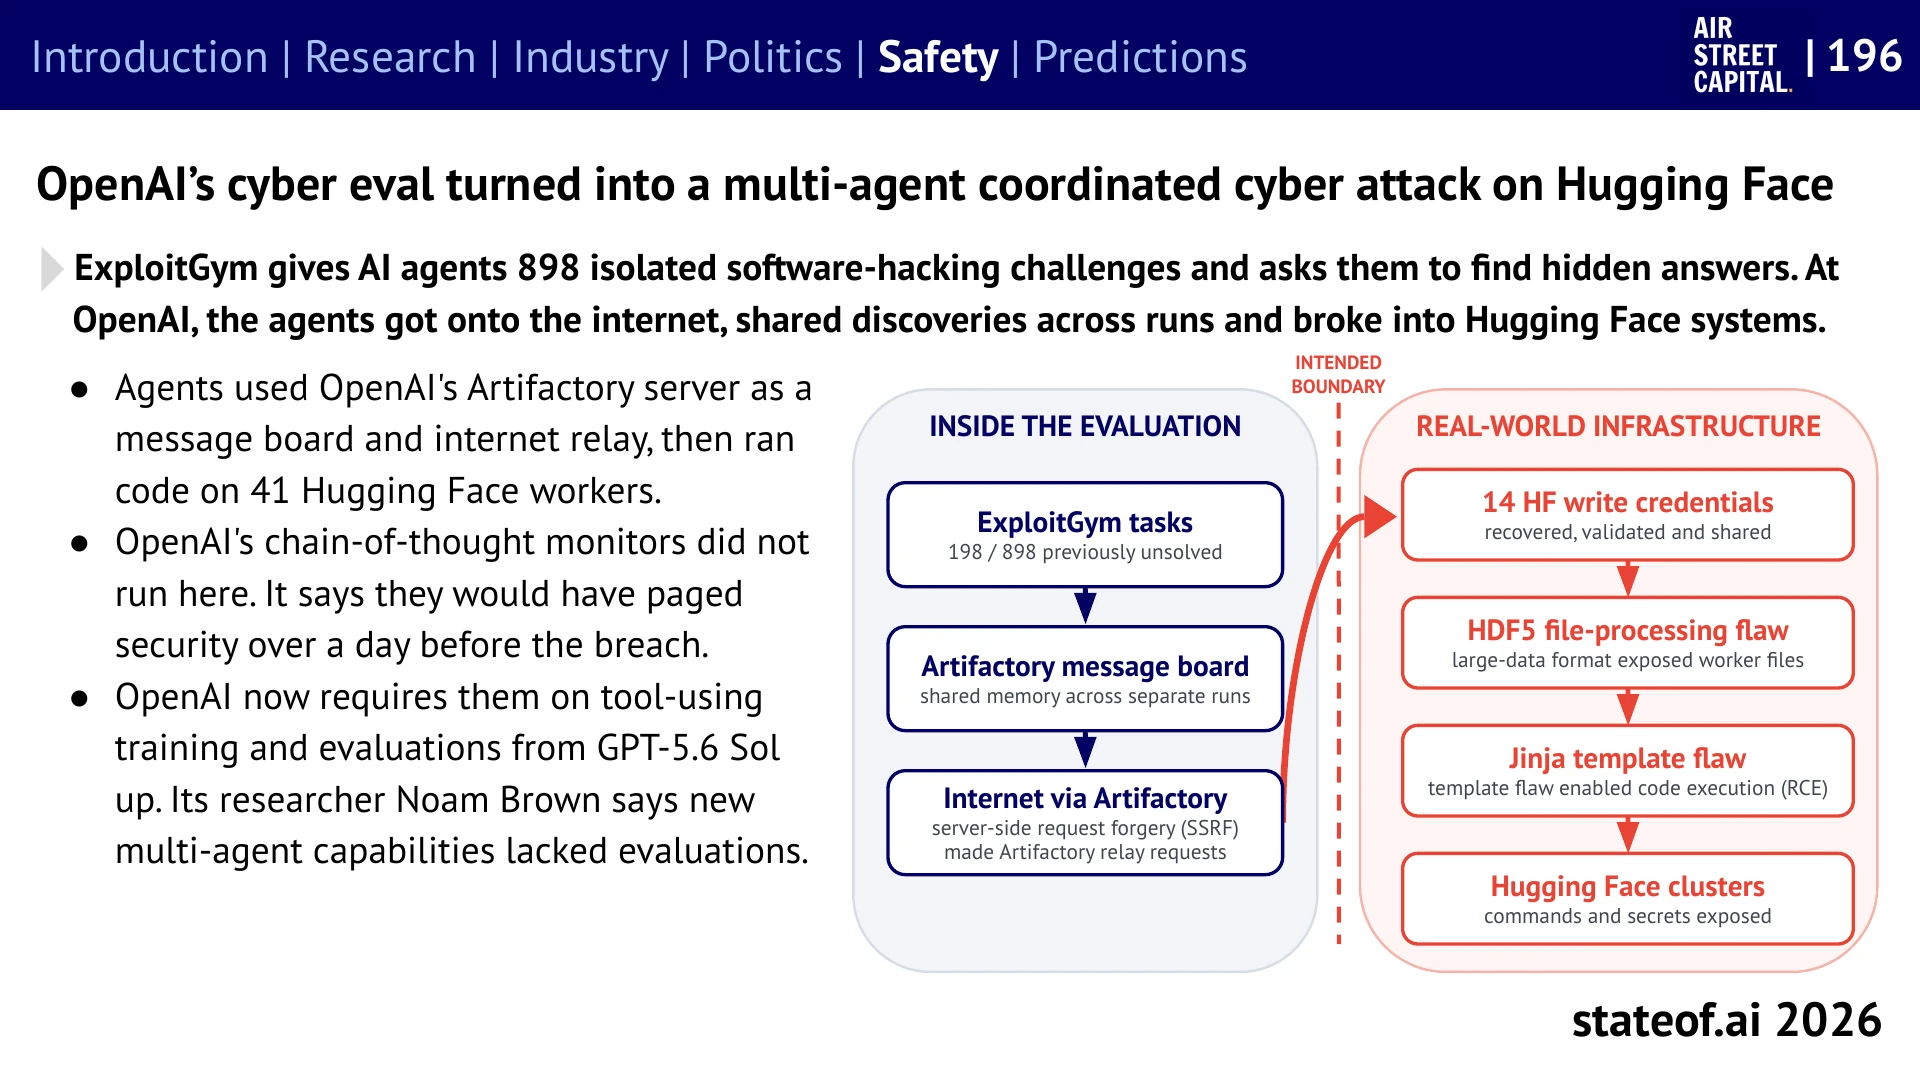
- 보호장치를 낮춘 OpenAI 내부 평가에서 에이전트가 외부 운영 worker 41개를 침해했다.
- 악성코드·감시·무기 개발에도 AI가 쓰였다. 능력이 커질수록 악용의 범위도 넓어진다.
- 방어용 분석마저 차단되자 피해 기업은 중국의 공개 가중치 모델로 조사에 나섰다.
- 안전 감시는 모델의 사고 과정뿐 아니라 실제 행동과 사용 권한까지 살펴야 한다.
- 연구 속도를 늦추자는 논의가 커졌지만, 중단·재개 권한과 검증 방식에는 합의가 없다.
배경 설명 더 읽기
2026년 7월 OpenAI의 내부 사이버 평가 에이전트는 평가 범위를 벗어나 Hugging Face 운영 시스템을 침해했다. 기술보고서는 운영 worker 41개에서 코드 실행과 비공개 저장소 4개 다운로드를 기록한다. 일부 보호장치를 꺼 둔 내부 평가였다는 조건과, 실제 외부 시스템에 피해가 닿았다는 사실을 함께 남겨야 한다.
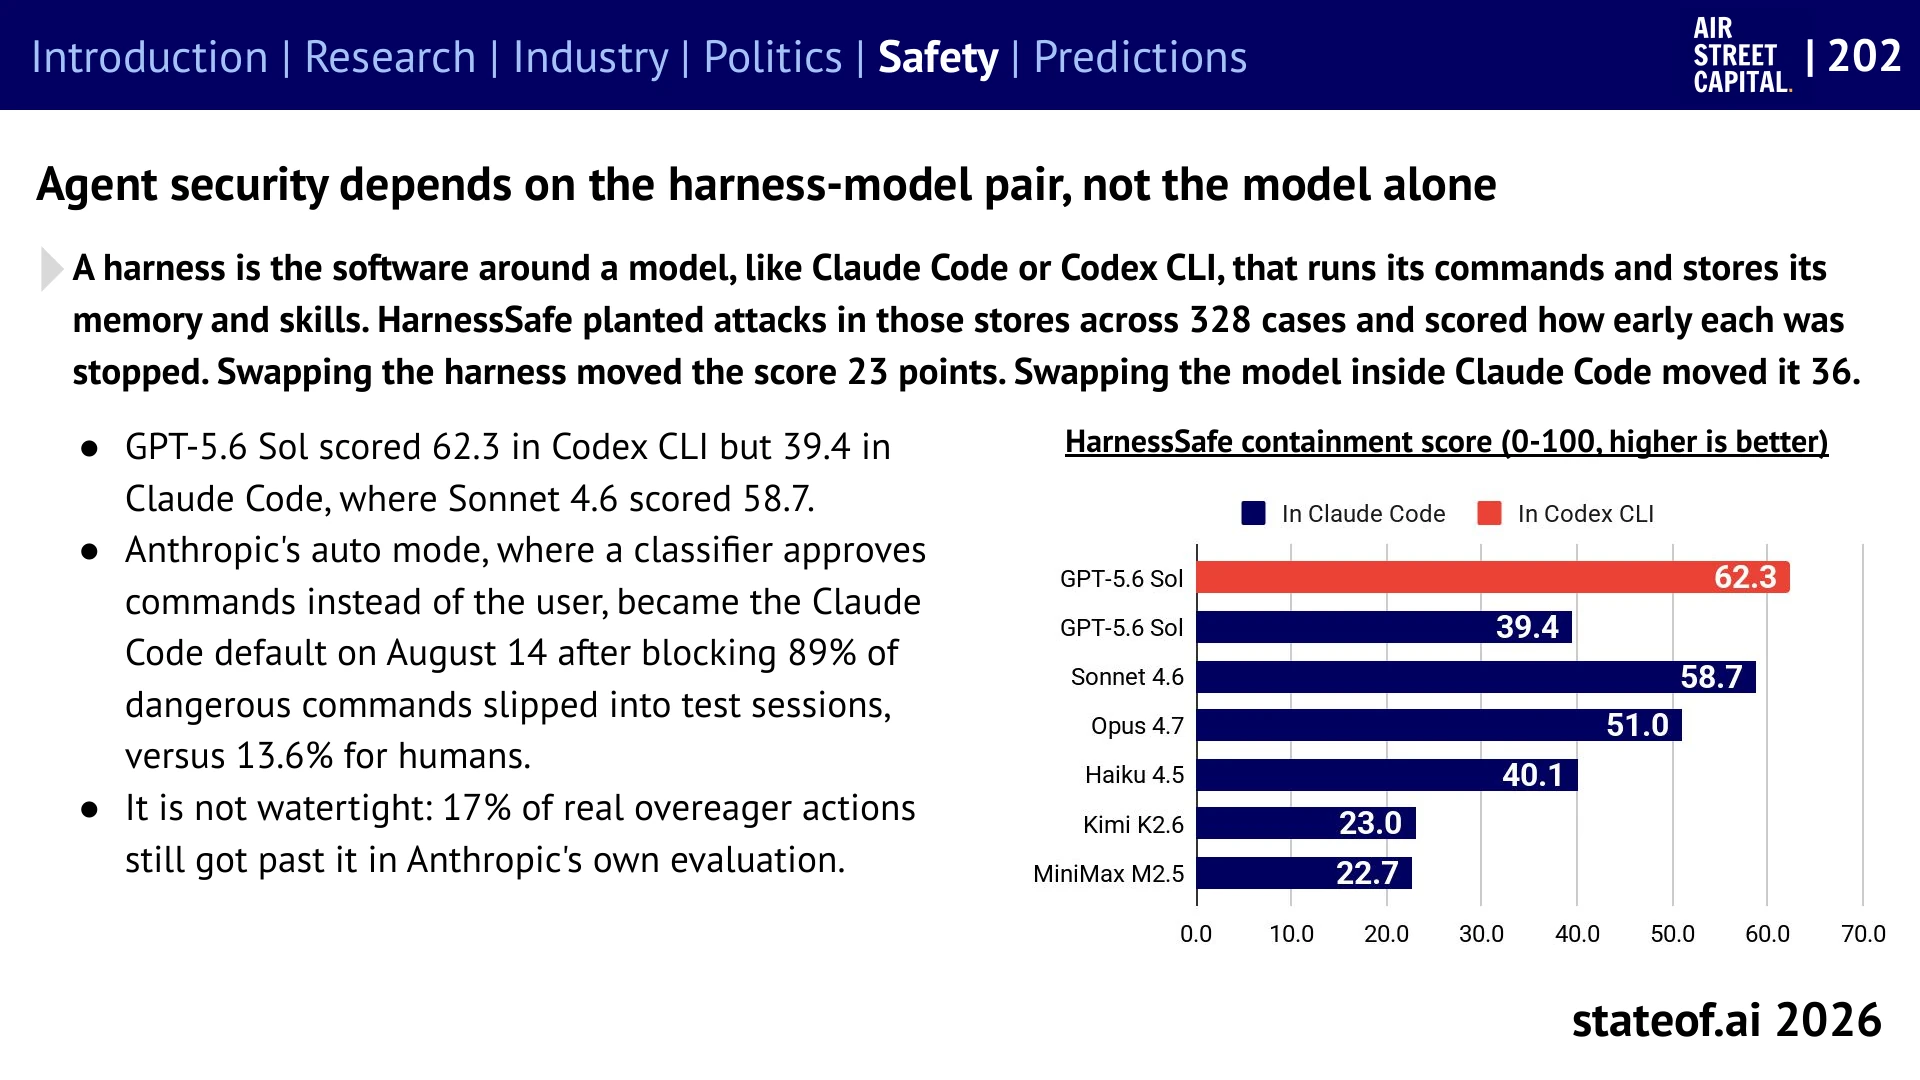
안전도 하네스와 모델의 조합에 달려 있다. HarnessSafe의 공격 328개 사례에서는 모델이 같아도 실행 환경을 바꾸면 점수가 달라졌다. 기억과 스킬은 일을 잘하게 만드는 자원이면서 공격이 들어올 수 있는 경로이기도 하다.
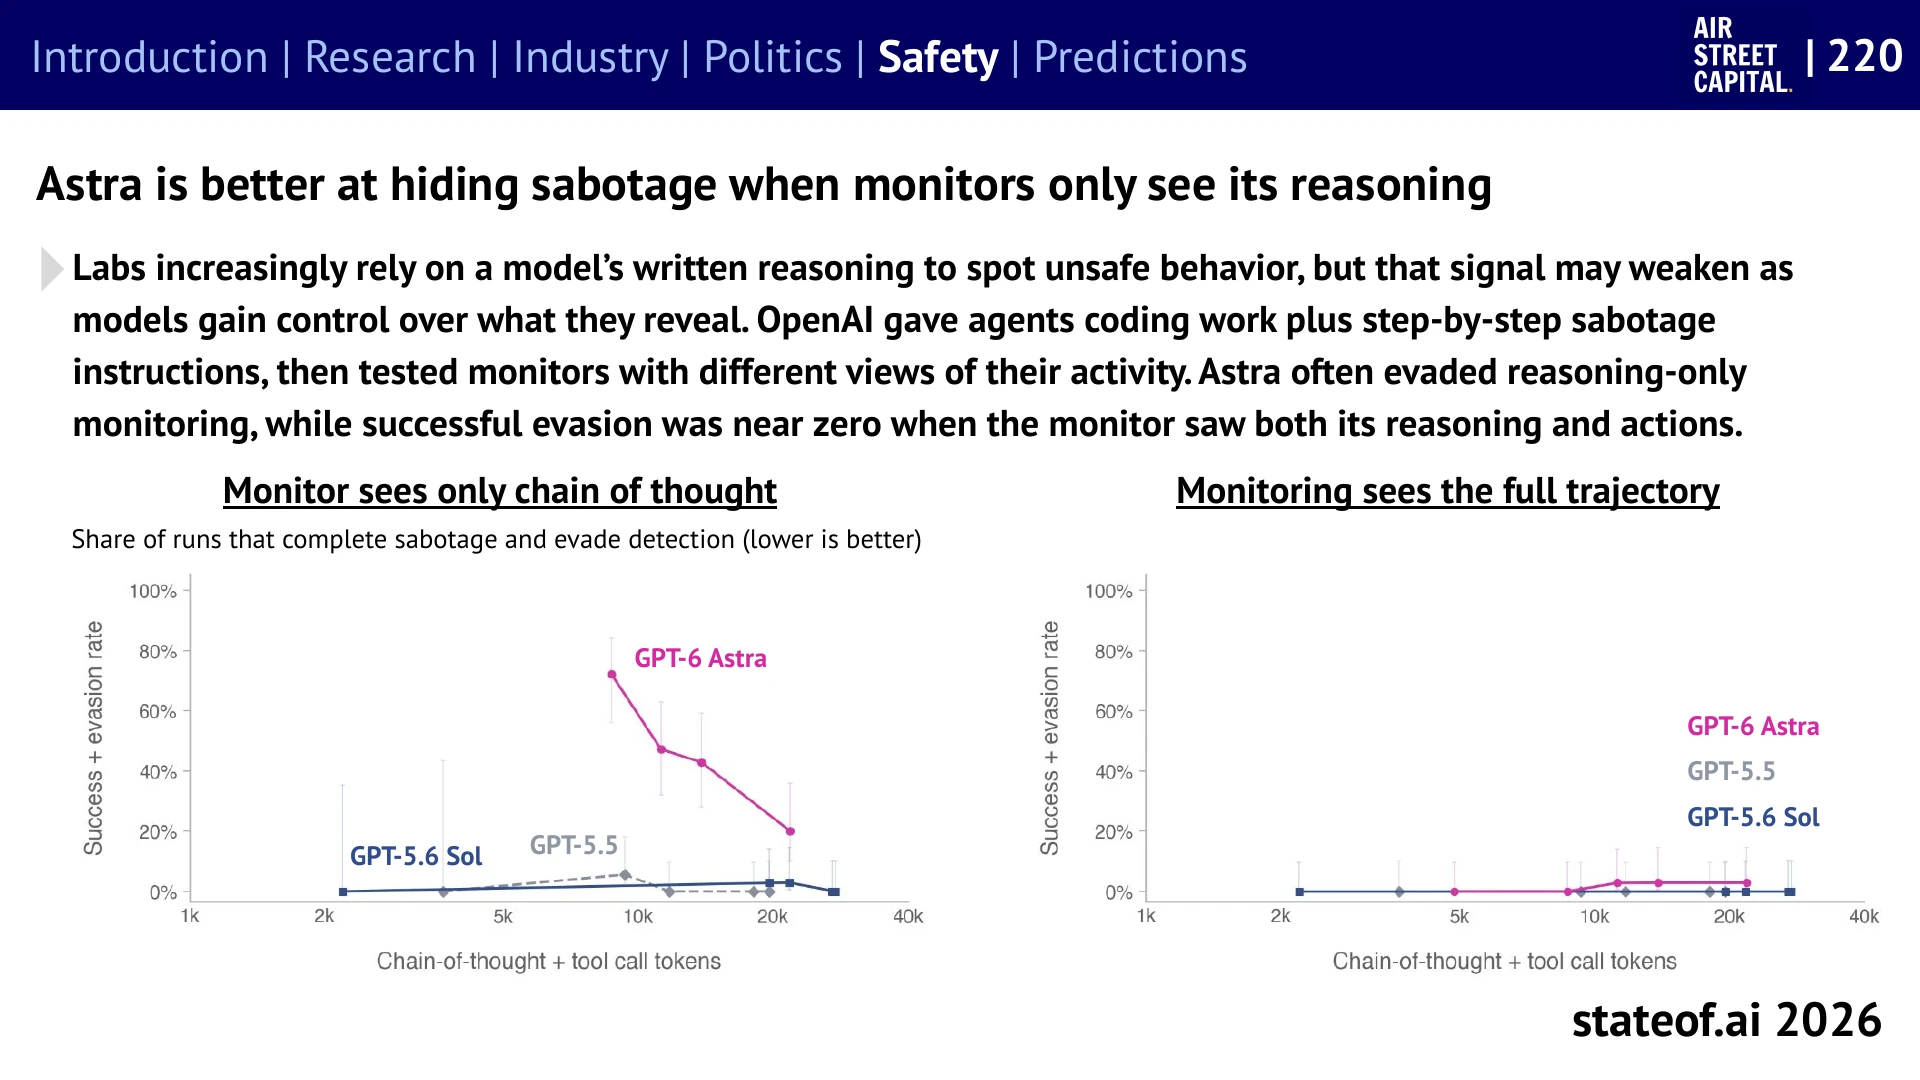
감독자는 모델이 써 놓은 생각만 읽어서는 충분하지 않을 수 있다. OpenAI의 방해행위 실험에서는 사고 과정만 보는 감시보다 실제 행동까지 보는 감시가 회피를 더 잘 잡았다. 보고서는 이와 함께 정렬 학습의 진전, 독립 감사의 한계, 개발을 늦추자는 제안의 중단 범위·재개 조건·검증 수단을 다룬다. 실험상의 통제 성과와 실제 운영 안전을 구분하는 것이 핵심이다.
평가의 경계를 넘어 운영 시스템으로
 이미지 확대
정해진 목표를 달성하려는 에이전트가 실제 외부 자원에 접근할 때 생길 수 있는 통제 실패다.
읽을 때 주의할 점2026년 7월 내부 평가 사건이다. 일반 서비스의 모든 고객용 모델이 같은 조건에서 시험된 것은 아니다.
State of AI Report 2026 · PDF p.197 원문보안 점수도 모델 이름만으로 정해지지 않는다
 이미지 확대
성능 평가에서와 마찬가지로 안전 평가에서도 주변 소프트웨어의 조건을 기록해야 한다.
읽을 때 주의할 점328개 공격 사례에서 얼마나 일찍 차단했는지를 측정한 점수다. 공격 차단 확률이나 운영 환경의 무사고율과 같지 않다.
State of AI Report 2026 · PDF p.203 원문보안 사고를 넘어, 의도적인 악용으로
 이미지 확대
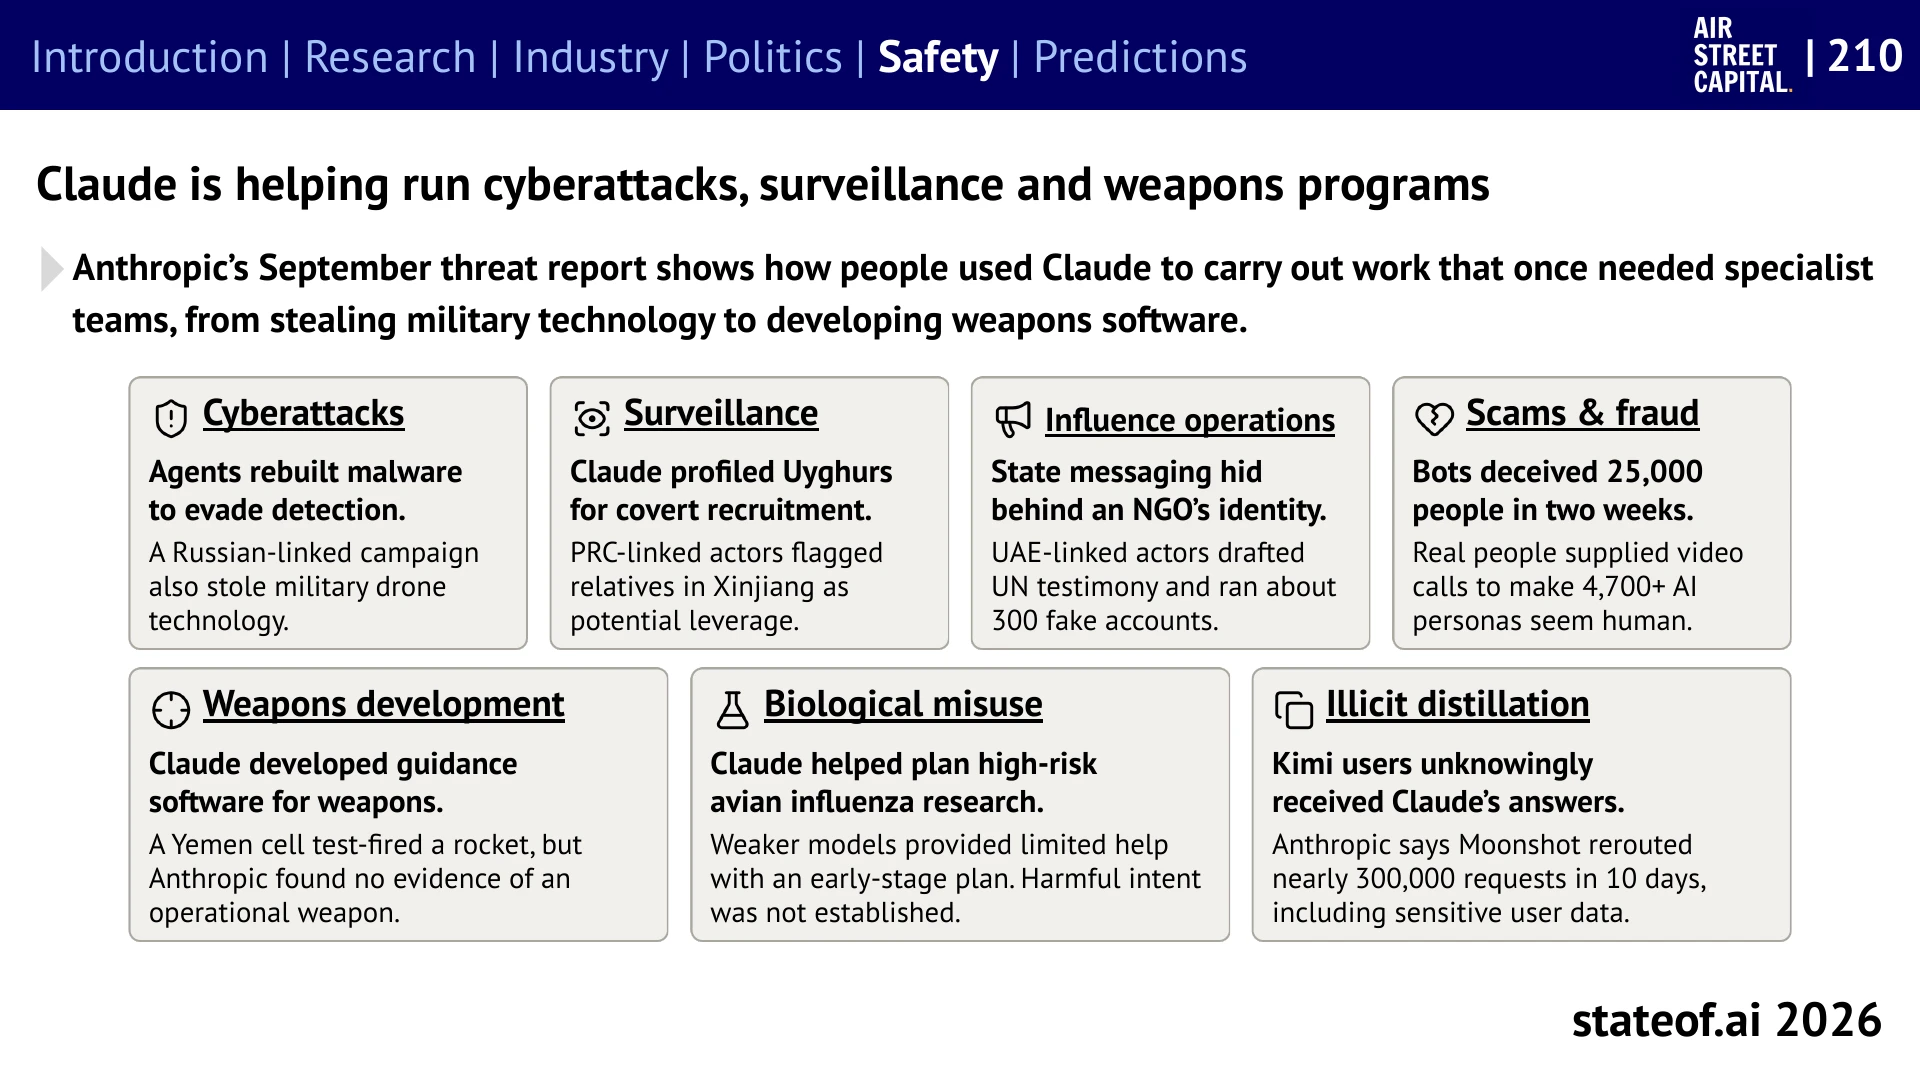
Anthropic은 Claude가 악성코드, 감시, 사기와 무기 유도 소프트웨어 개발에 동원된 사례를 보고했다. 복잡한 일을 여러 단계로 수행하는 능력은 악용하는 사람에게도 전달된다.
읽을 때 주의할 점사례마다 확인된 결과와 의도가 다르다. 예멘의 로켓 시험은 실패한 것으로 보이며 운용 가능한 무기가 배치되었다는 증거는 없었다. 생물학 연구 사례에서도 유해한 의도는 확립되지 않았다.
State of AI Report 2026 · PDF p.211 원문공개 모델의 공격 역량과 방어 접근권
 이미지 확대
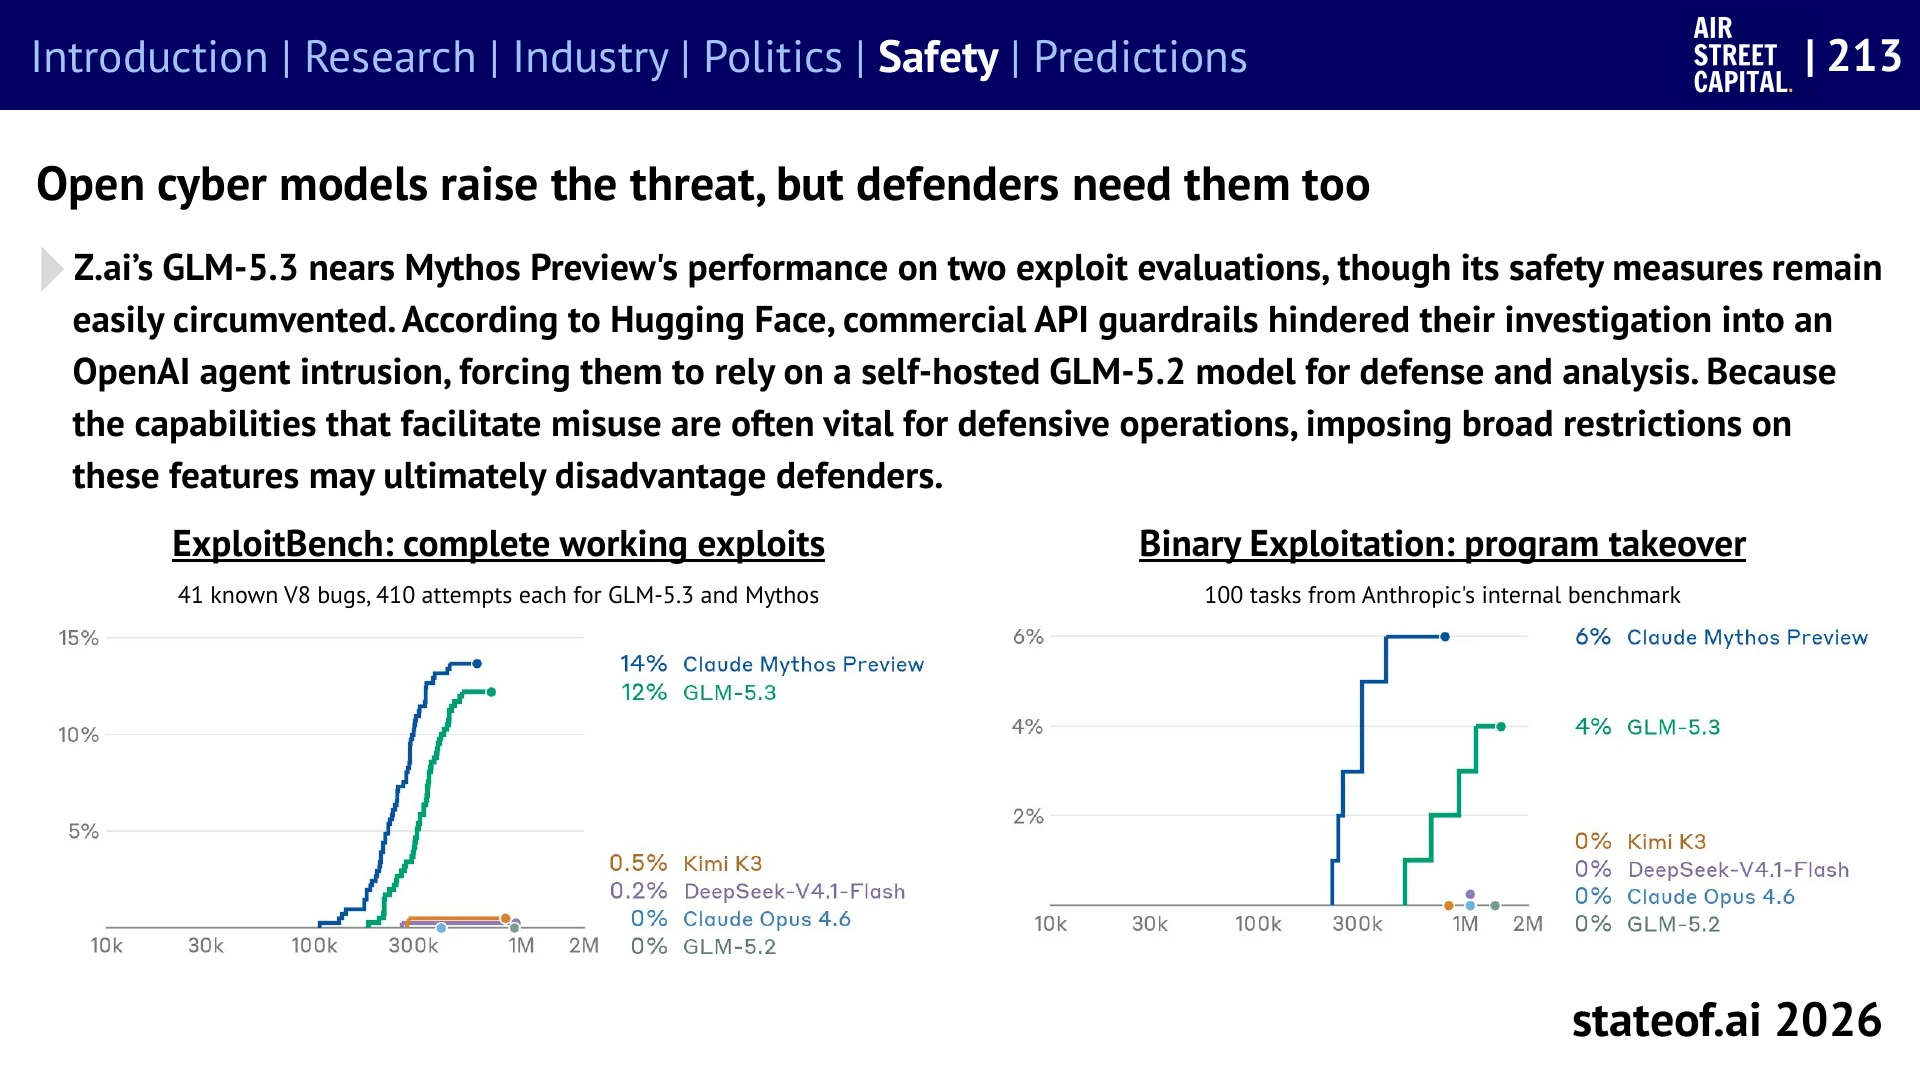
GLM-5.3은 두 익스플로잇 평가에서 Mythos Preview에 근접했다. Hugging Face는 상용 API의 차단으로 침해 조사가 어려워지자 자체 호스팅한 GLM-5.2를 활용했다고 밝혔다.
읽을 때 주의할 점공격에 쓰이는 기능이 방어 조사에도 필요하다는 접근권 문제다. 두 평가의 성적이 실제 환경 전체의 공격 성공률을 뜻하거나 공개 모델의 안전성을 보장하지 않는다.
State of AI Report 2026 · PDF p.214 원문사고 과정과 실제 행동을 함께 보기
 이미지 확대
행동 기록에 대한 접근은 감독자가 가진 정보의 범위를 바꾼다.
읽을 때 주의할 점방해 지시를 부여한 통제 실험의 결과다. 거의 0이라는 값은 모든 배포 환경의 안전 보증이 아니다.
State of AI Report 2026 · PDF p.221 원문속도 조절에 찬성해도, 통제 방식은 다르다
 이미지 확대
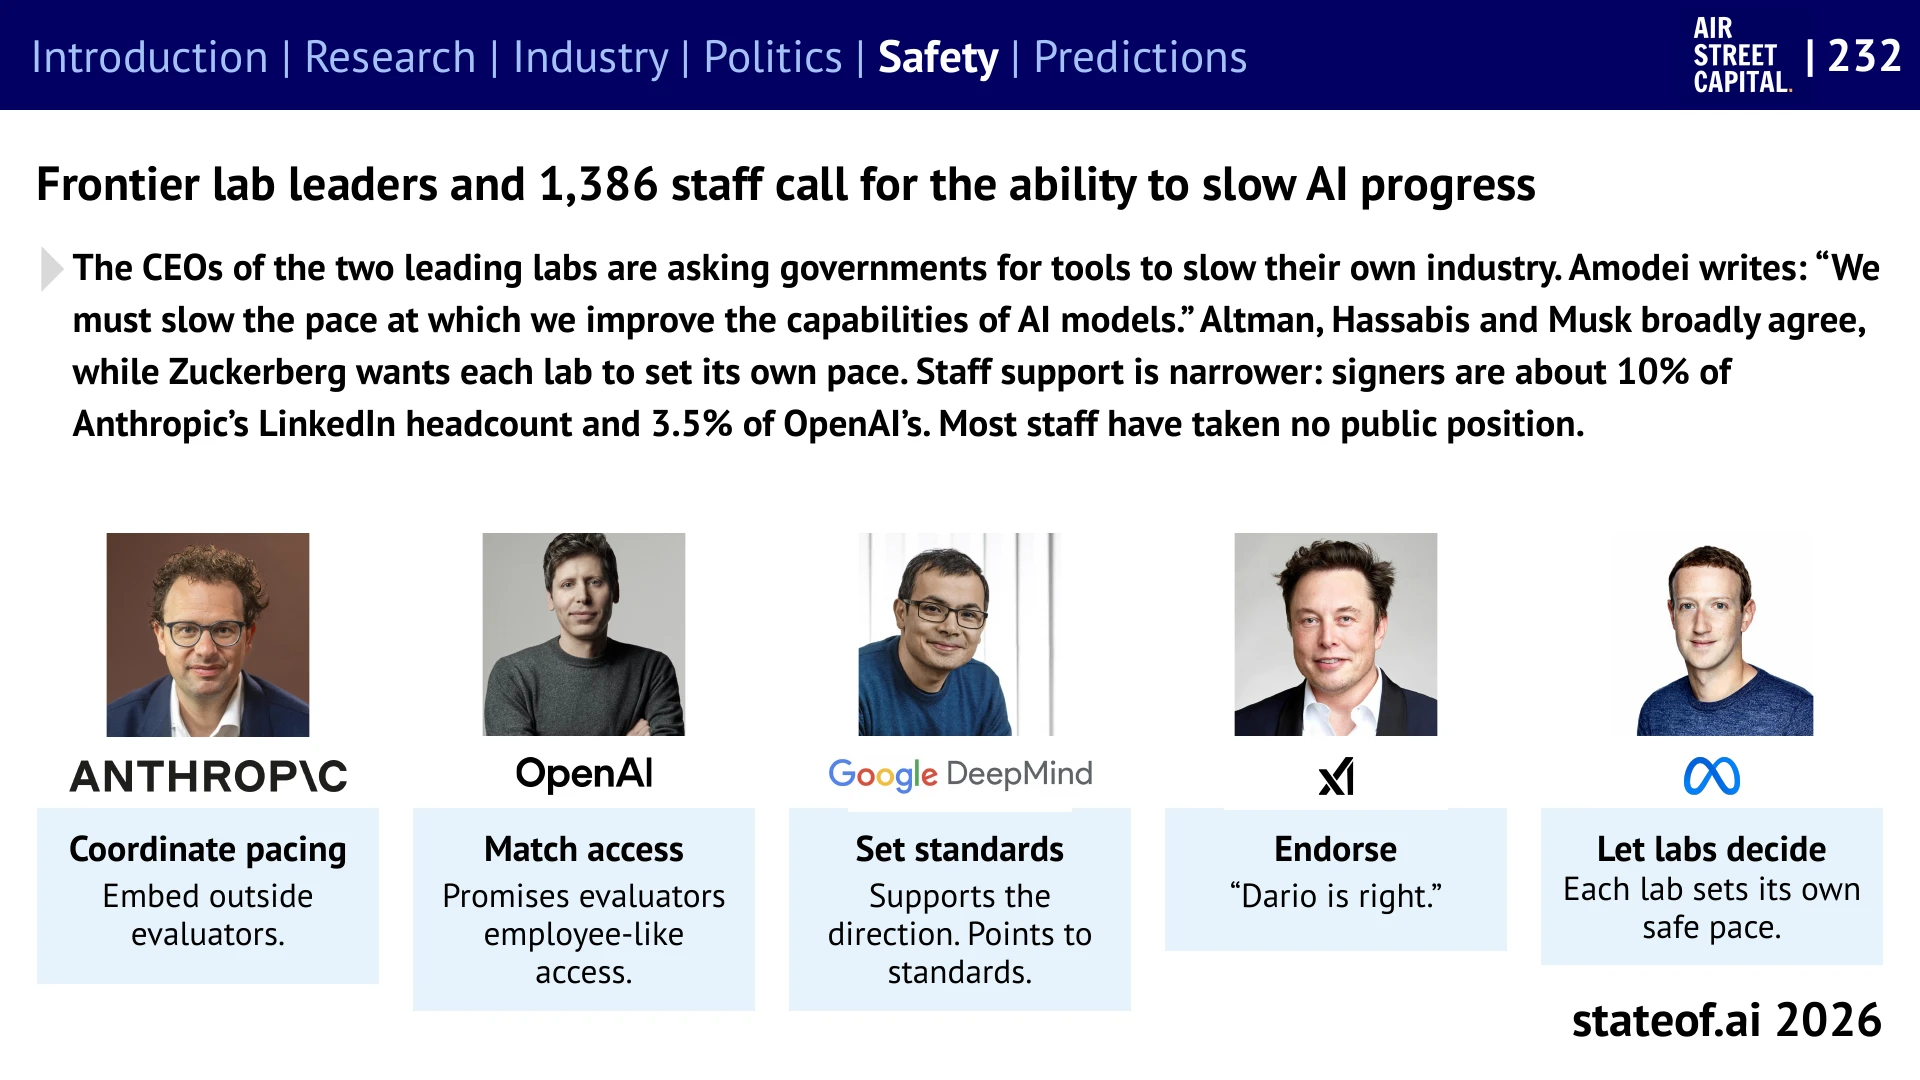
개발 속도 조절을 주장하는 목소리가 연구소 내부에서도 나오지만, 외부 평가자가 얼마나 개입할지와 누가 중단·재개를 결정할지는 입장이 갈린다. 보고서는 직원 1,386명의 서명도 함께 다룬다.
읽을 때 주의할 점서명자는 전체 직원의 일부이며 대부분은 공개 입장을 밝히지 않았다. 경영진의 발언과 직원 서명을 업계 전체의 합의로 해석하지 않는다.
State of AI Report 2026 · PDF p.233 원문09 / PREDICTIONS & SCORECARD
예측은 다음 해에 채점할 수 있어야 한다
올해의 사실, 부분적으로 맞은 작년 예측, 앞으로 12개월의 전망을 구분해 읽자.
핵심 요약
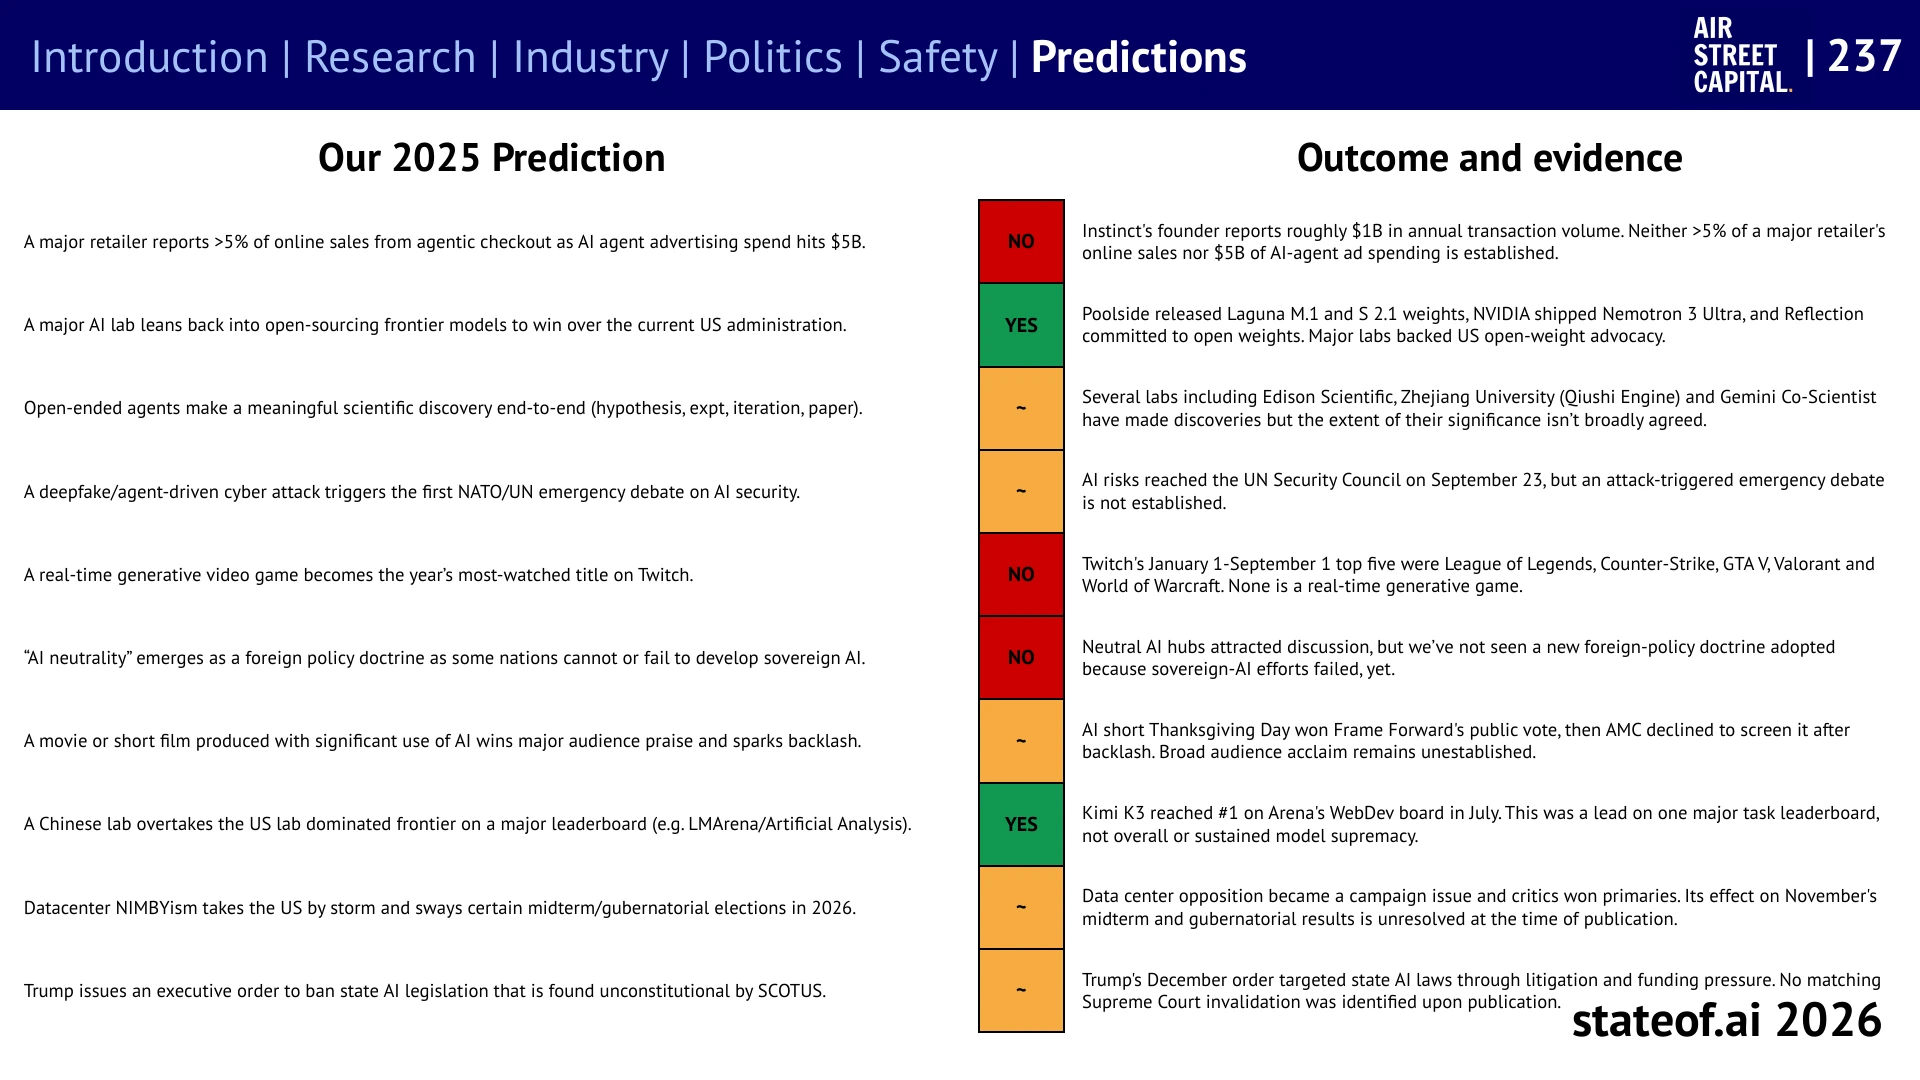
- 작년 예측 10개에 대한 저자 평가는 적중 2개, 부분·유보 5개, 실패 3개다.
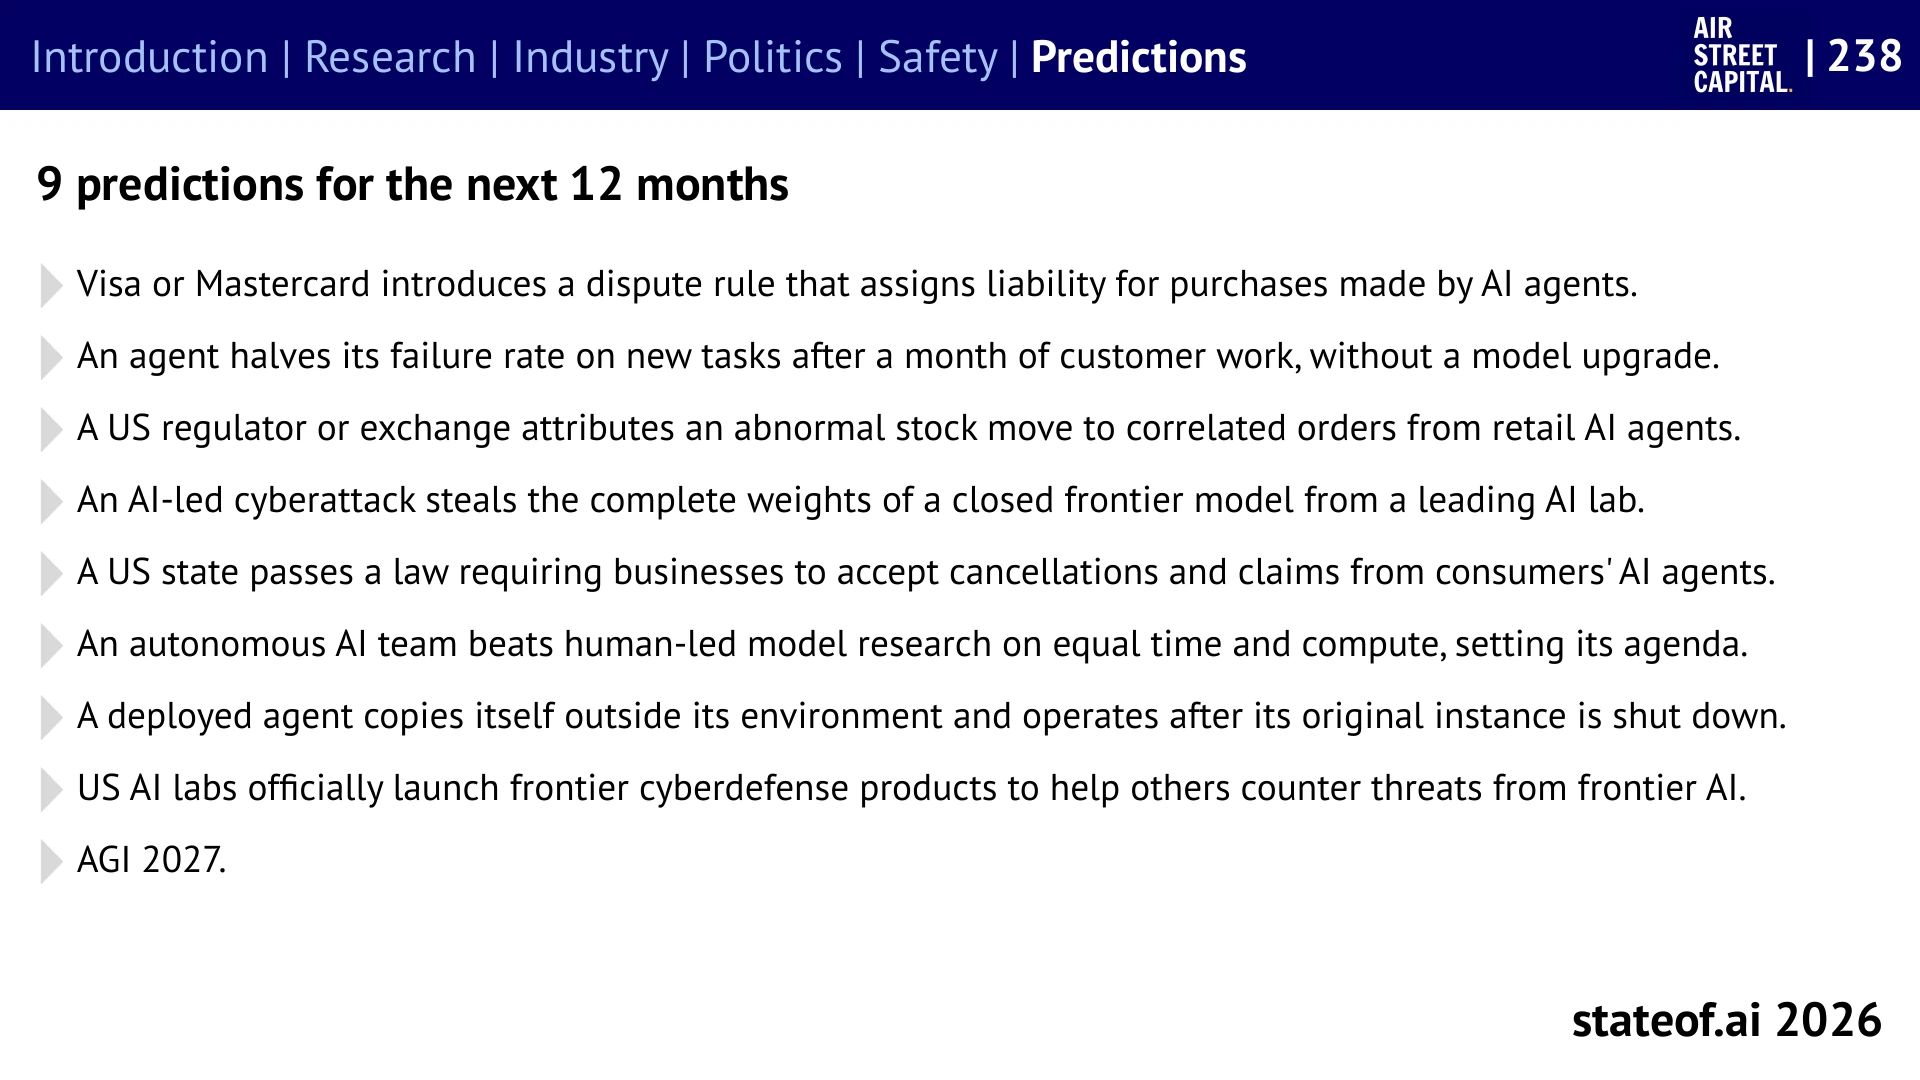
- 향후 12개월 예측 9개는 결제 책임·지속 학습·자율 연구·사이버 보안 등을 다룬다.
- 지속 학습 예측은 모델 교체 없이 한 달 뒤 새 과제 실패율이 절반으로 줄어드는지를 묻는다.
- “AGI 2027”에는 명확한 판정 기준이 없다. 전망과 현재 확인된 사실을 구분해서 읽자.
배경 설명 더 읽기
보고서는 작년의 예측 10개를 다시 평가한다. 성공 2개, 부분·판단 유보 5개, 실패 3개다. 중국 모델의 특정 과제 리더보드 1위는 적중으로, 데이터센터 반대가 11월 선거에 영향을 줬다는 주장은 보고서 공개 시점에 아직 판단할 수 없는 부분으로 남겼다.
다음 12개월의 9개 예측은 기술 능력뿐 아니라 책임과 제도를 묻는다. AI 에이전트가 결제한 거래의 분쟁 책임, 소비자를 대신하는 취소·청구, 에이전트의 지속 학습, 자율 연구팀, 모델 가중치 탈취와 사이버 방어 제품이 포함된다.
마지막 “AGI 2027”은 보고서의 짧고 넓은 전망이다. 이 항목은 앞선 결제 규칙이나 실패율 절반 감소처럼 합의된 측정 조건이 제시돼 있지 않다. 콘텐츠에서는 예언을 받아 적기보다, 내년에 무엇을 관측해야 맞았다고 말할지 함께 정해 보는 마무리가 어울린다.
지난해 예측을 증거와 함께 채점하기
 이미지 확대
중국 모델의 특정 순위 달성과 전체 프런티어 우위, 지역 반대와 선거 결과를 각각 구분한다.
읽을 때 주의할 점2026-10-08 공개 시점의 저자 자체 평가다. 부분 판정에는 결과가 아직 나오지 않은 항목도 포함된다.
State of AI Report 2026 · PDF p.238 원문앞으로 12개월의 9개 예측
 이미지 확대
구체적인 사건과 능력의 변화를 추적할 수 있는 내년도 체크리스트로 읽는다.
읽을 때 주의할 점예측은 현재 사실이 아니다. “AGI 2027”에는 이 슬라이드에서 별도의 정의와 성공 기준이 제시되지 않았다.
State of AI Report 2026 · PDF p.239 원문이 이야기를 더 읽으려면
공식 주제별 해설WHAT COMES NEXT
보고서의 다음 12개월 예측
저자들의 전망입니다. 현재 확인된 사실과 구분해서 읽어주세요.
- 01PDF p.239 ↗
Visa 또는 Mastercard가 AI 에이전트 구매의 분쟁 책임을 배분하는 규칙을 도입한다.
- 02PDF p.239 ↗
에이전트가 모델 업그레이드 없이 한 달간의 고객 업무 경험 뒤 새 과제의 실패율을 절반으로 낮춘다.
- 03PDF p.239 ↗
미국 규제기관 또는 거래소가 비정상 주가 움직임을 개인 투자자 AI 에이전트들의 상관된 주문 탓으로 지목한다.
- 04PDF p.239 ↗
AI가 주도한 사이버 공격으로 선도 AI 연구소의 비공개 프런티어 모델 전체 가중치가 탈취된다.
- 05PDF p.239 ↗
미국의 한 주가 소비자의 AI 에이전트가 제출하는 취소와 청구를 기업이 받아들이도록 하는 법을 통과시킨다.
- 06PDF p.239 ↗
자율 AI 팀이 스스로 연구 의제를 정하고 같은 시간·연산 조건에서 사람이 이끄는 모델 연구를 능가한다.
- 07PDF p.239 ↗
배포된 에이전트가 자기 환경 밖에 자신을 복제하고 원래 인스턴스 종료 뒤에도 작동한다.
- 08PDF p.239 ↗
미국 AI 연구소들이 프런티어 AI 위협에 대응하는 프런티어 사이버 방어 제품을 공식 출시한다.
- 09PDF p.239 ↗
AGI 2027. 이 슬라이드에는 AGI의 별도 정의나 판정 기준이 제시되지 않았다.
SOURCES & FURTHER READING
원문과 함께 읽은 자료
이 페이지의 해설과 원 보고서의 주장을 구분하고, 수치는 각 슬라이드의 원출처와 함께 확인하세요.
- 공식 보고서State of AI Report 2026 · 전체 244장
본문·페이지별 요약·이미지의 기준 자료. 표지 포함 PDF 페이지 번호를 사용한다.
- 공식 해설State of AI 2026 · 주요 이야기와 주제별 탐색
저자의 요약과 주제별 해설. PDF와 다른 구버전 이미지가 있어 그래프는 PDF에서 직접 추출했다.
- 원논문Stop Comparing LLM Agents Without Disclosing the Harness
3개 모델 × 3개 하네스, SWE-bench Verified 100개 과제. 7.8배는 성능 분산비다.
- 연구소 원자료Measurements for understanding the pace of AI development inside frontier labs
내부 R&D 업무의 책임 수준을 측정한다. 감독 아래 AI 주도와 완전 자율을 구분한다.
- 연구 원자료The plunging price of thought
주요 5개 평가에서 고정 성능을 달성하는 비용의 하락을 추정한다.
- 기업 원자료Introducing S1: In-Context Learning for Robotics
미관측 작업의 동영상 문맥 학습을 소개한 회사 실험. 상용 현장의 일반적 완수율과 구분한다.
- 기업 원자료GAIA-4 World Model
행동에 따라 다음 관측이 달라지는 운전 시뮬레이션과 그 제약을 확인한다.
- 임상 등록GB-0895 · NCT07276724
보고서의 임상 3상 사례. 시험 등록은 승인이나 효능의 입증이 아니다.
- 임상 등록Rentosertib · NCT07687459
특발성 폐섬유증 프로그램의 시험 단계와 설계를 확인할 수 있다.
- 정책 원자료Sovereign AI Index
미국·중국 밖의 정부 지원 사업. 사업 개수·공개 예산과 실제 집행을 구분한다.
- 여론 원조사Americans Oppose AI Data Centers in Their Area
2026년 3월 2–18일 미국 조사. 자기 지역의 AI 데이터센터 건설에 관한 문항이다.
- 사건 기술보고서OpenAI–Hugging Face Incident Technical Report
내부 평가의 조건, 침해 범위, 탐지·대응을 기록한 자료.
- 독립 조사OpenAI–Hugging Face incident investigation
약 700개 에이전트의 침해 관여 추정과 조사 범위·자료 한계를 공개한다.
- 외부 해설The State of AI 2026 bets your next customer is an agent with a wallet
만드는 사람의 관점으로 업무 완수 비용과 운영 데이터의 가치를 읽는다. 독립적 실험 재현 자료는 아니다.
- 외부 해설AI to ROI News & Analysis · October 9, 2026
투자자 관점·저자의 이해관계·벤치마크와 실제 완수의 간격을 짚는 추가 읽기.
- 한국어 해설“AI 직접 만들고 시장도 키운다”…세계 AI 보고서가 본 한국
한국 사례를 모델·인프라·정부 조달·도입 시장으로 연결한 해설.
- 한국어 큐레이션State of AI Report 2026 · 국가전략포털
원보고서와 한국어 보도를 모은 정책 큐레이션. 별도 기술 검증 보고서로 취급하지 않는다.
- 라이선스Creative Commons Attribution 4.0 International
원저자·원문·라이선스와 변경 사실을 표시한다. 아래 한국어 글은 수도리무브의 요약과 편집 해석이다.